Claude Opus 5.5とGPT-6 Astra|どちらを使うべきか

「Claude Opus 5.5とGPT-6 Astra、結局どちらを使えばいいのか」「単価が安いほうで足りるのか、高いほうに理由があるのか」——9月に2つの新モデルが相次いで出て、道具を選び直す立場の人ほどこの迷いを抱えます。
結論から言うと、コーディングやターミナル作業、知識労働が中心ならOpus 5.5、業務自動化や科学系のターミナル作業ではAstraも有力です。単価はOpus 5.5のほうが入出力とも2.5分の1ですが、Anthropicの公式表でもAstraが上回る項目が2つあり、全方位でOpus 5.5が勝つわけではありません。
株式会社Fyveは、社内の開発と業務の自動化をClaude Codeで回し、Codexもレビューや画像生成の担当として並行して使っています。両方の環境を持つ立場から、単価・公式の比較表とその測定条件・乗り換えの手間の順に、どちらを使うべきかを整理します。
Opus 5.5そのものの変更点を先に押さえたい方は、全体像をまとめたこちらの記事からどうぞ。
先に結論:用途別にどちらを使うか
判断の軸は「何の作業に使うか」と「いまどちらの環境が整っているか」の2つです。結論を先に並べ、根拠の数字は次の章以降で示します。
- コーディング・ターミナル上のエージェント作業:Opus 5.5。公式表で差がもっとも大きく開いた領域で、単価も安い
- 職種ごとの実務や難問の推論などの知識労働:Opus 5.5。調査・資料作成に近い項目で、公式表の差がはっきりしている
- 業務自動化:どちらも有力。公式表ではAstraがわずかに上で、ほぼ互角。これから組むなら単価の安いOpus 5.5、すでにCodexやChatGPTで自動化が動いているならAstraのままでよい
- 科学系のターミナル作業:Astra。Anthropic自身の表でもAstraが上
- どちらか一方の環境がすでに整っている:上の差だけを理由に乗り換えない。乗り換えの手間は単価差より大きくなることがある。なおClaude Code(v2.1.280以降)を使っているなら、既定モデルはすでにOpus 5.5に切り替わっている
ここで使っている数値はすべてAnthropicが発表した比較表から引いたもので、独立した第三者による再現ではありません(2026年9月23日時点)。この表をどう読むかは、後の2つの章で扱います。
単価の差:Opus 5.5はAstraの2.5分の1
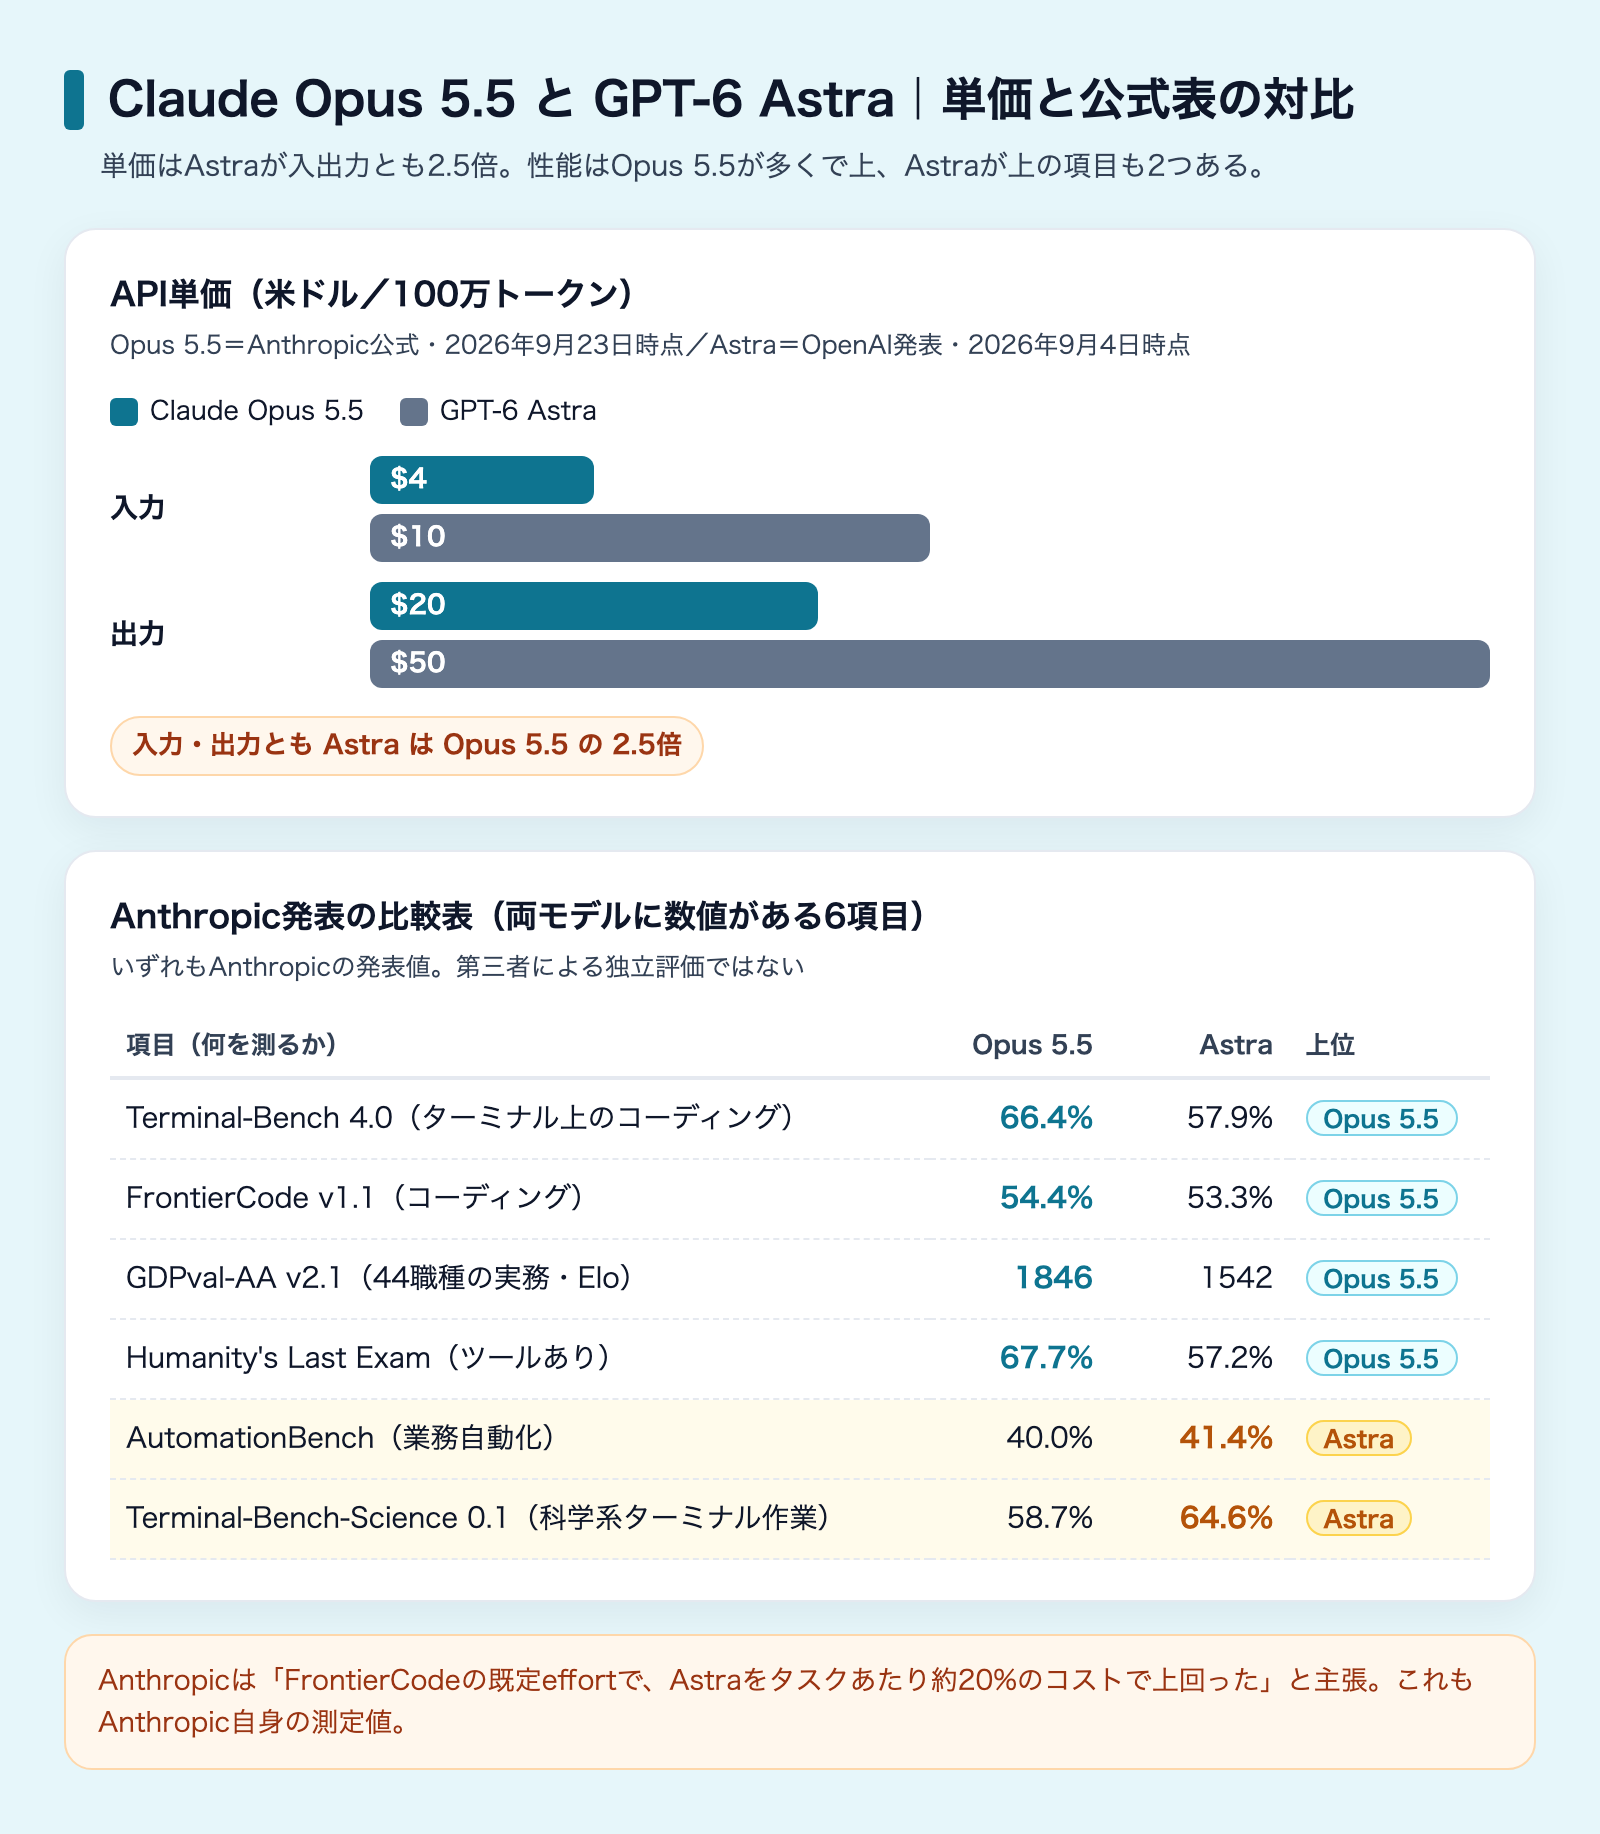
API(使ったトークン量に応じて払う従量課金)の単価は、次のとおりです。いずれも100万トークンあたりの米ドル表記です。
- Claude Opus 5.5:入力 $4/出力 $20(Anthropic公式・2026年9月23日時点)
- GPT-6 Astra:入力 $10/出力 $50(OpenAI発表・2026年9月4日時点)
入力も出力も、Astraの単価はOpus 5.5のちょうど2.5倍です。たとえば入力100万トークン・出力20万トークンを使う仕事なら、同じトークン量で済むと仮定した場合、Opus 5.5は$4+$4で$8、Astraは$10+$10で$20になります。
ただし実際の請求額は、単価だけでは決まりません。同じ仕事でも、モデルによって使うトークンの量が変わるからです。単価が安くても、何度も考え直して長い出力を返すモデルなら、合計では高くつくこともあります。
この点について、Anthropicは発表で「FrontierCode(コーディングのベンチマーク)の既定effortで、GPT-6 Astraをタスクあたり約20%のコストで上回った」と主張しています。effortとは、モデルが考える深さの設定です。この数字はAnthropicが自社で測ったもので、第三者による再現はまだ出ていません(2026年9月23日時点)。どんな条件同士を比べた数字なのかは、後の章で掘り下げます。
もう1つ押さえておきたいのは、この単価差が効くのはAPIの従量課金だけだという点です。Claude Codeを月額プランで使っている場合、Opus 5.5のトークン単価がそのまま請求されるわけではありません。月額プランでの使い方や、キャッシュ・Batchを含めた細かな単価は、それぞれ専門の記事に任せます。
いずれの単価も改定されることがあります。契約前に、Anthropicの料金ページとOpenAIのGPT-6 Astraのモデルページで最新の価格を確認してください。
なお、Anthropicの上位モデルであるFable 5.1の単価は入力$10/出力$50で、Astraとまったく同じです(2026年9月23日時点)。同じ価格帯のモデル同士をどう比べるかは、こちらで扱っています。
GPT-6 AstraとClaude Fable 5.1|どちらを使うべきか
 読者特典・無料ダウンロード最新AI「4モデル」、実務で比べてみた。無料でダウンロード →
公式の比較表で見る得意・不得意
Anthropicは発表で、Opus 5.5とほかのモデルを並べた比較表を出しています。そのうち、Opus 5.5とGPT-6 Astraの両方に数値がある6項目を抜き出しました。
- Terminal-Bench 4.0(ターミナル上のエージェント型コーディング):Opus 5.5 66.4%/Astra 57.9%
- FrontierCode v1.1(コーディング):Opus 5.5 54.4%/Astra 53.3%
- GDPval-AA v2.1(44職種の実務・Eloレーティング):Opus 5.5 1846/Astra 1542
- Humanity's Last Exam(ツールあり・難問推論):Opus 5.5 67.7%/Astra 57.2%
- AutomationBench(業務自動化):Opus 5.5 40.0%/Astra 41.4%
- Terminal-Bench-Science 0.1(科学系のターミナル作業):Opus 5.5 58.7%/Astra 64.6%
差が大きいのは3項目、FrontierCodeはほぼ互角
Opus 5.5が上回った4項目のうち、差がはっきりしているのはTerminal-Bench 4.0(8.5ポイント差)、GDPval-AA(304点差)、Humanity's Last Exam(10.5ポイント差)の3つです。ターミナルで手を動かすコーディング、職種ごとの実務、難しい推論のいずれでも、Anthropicの表ではOpus 5.5が上に出ています。
一方で、FrontierCodeの差は1.1ポイントしかありません。「コーディングならOpus 5.5が圧勝」とまでは読めず、この項目では両者はほぼ並んでいると見るのが正確です。Anthropicが「約20%のコストで上回った」と主張しているのもこのFrontierCodeなので、強調しているのは点数の差というより費用の差だと読めます。
Astraが上回った2項目
AnthropicはAstraが上回った項目も表に載せています。業務自動化(AutomationBench)は1.4ポイント差なので、どちらを選んでも大きな差は出にくいと考えてよいでしょう。
科学系のターミナル作業(Terminal-Bench-Science)は6ポイント近い差があります。研究データの処理や科学計算をターミナルで回す用途なら、単価が2.5倍でもAstraを第一候補に置く理由になります。
表に出ない制約:セキュリティ関連の作業
比較表には出てきませんが、Anthropicの発表によると、Opus 5.5ではサイバーセキュリティ系のタスクの大半が、セーフガード(安全のための制御)によってOpus 4.8に回されます。脆弱性の調査などが主な用途なら、Opus 5.5の点数をそのまま当てにしないほうがよいでしょう。
この表を読むときの注意
- 両方ともAnthropicの表から引いた値:独立した評価機関の数値は、Opus 5.5についてはまだ出ていません(2026年9月23日時点)
- 表に無い項目は「負けた」という意味ではない:CursorBench、OSWorld 2.0、ChartographyはAstraの欄が空欄です。比較できないだけで、Astraが苦手という根拠にはなりません
- ベンチマークは自分の仕事の代わりにならない:点数の差がそのまま自社の作業の差になるとは限りません
各ベンチマークが何を測っているのか、発表値をどこまで信じてよいのかは、こちらの記事で項目ごとに解説しています。
表の数字は、どのeffortで出た値か
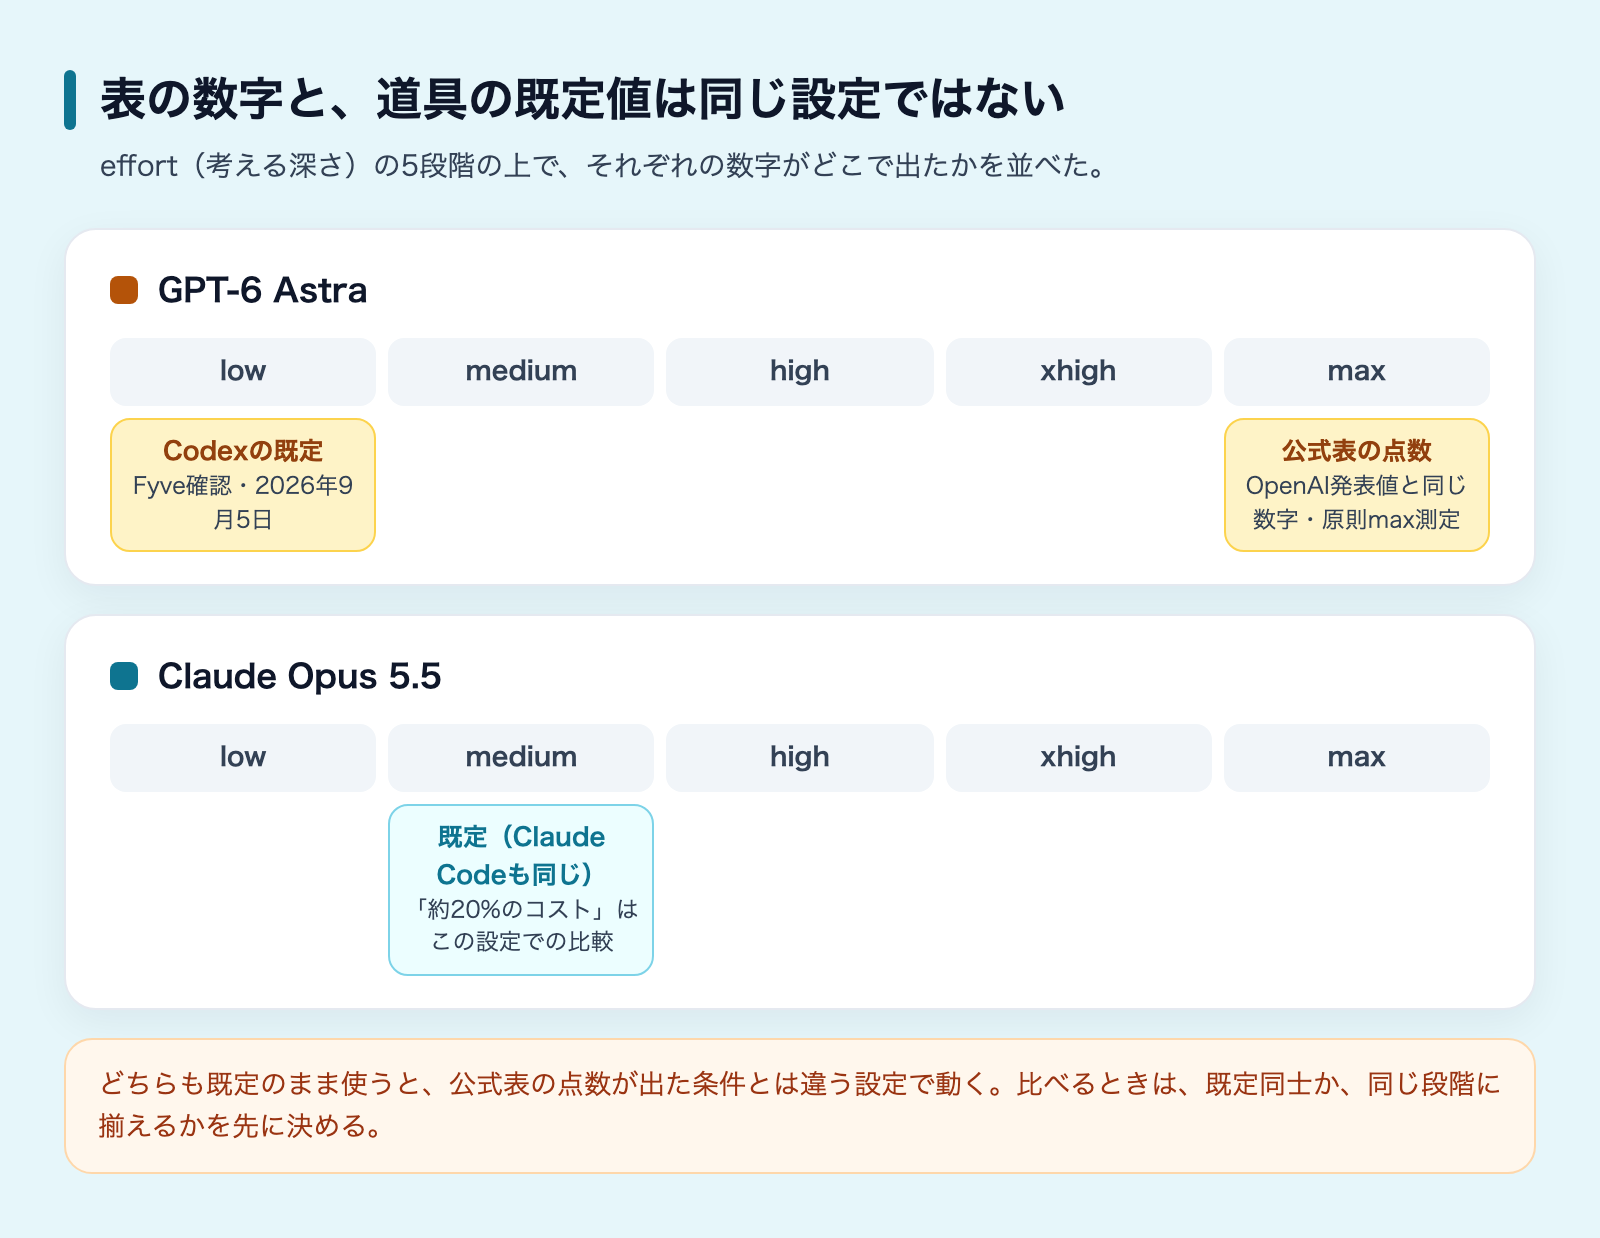
2つのモデルを比べるときに見落としやすいのが、effort(考える深さ)の条件です。同じモデルでも、effortを上げれば点数は上がりやすい一方、時間とトークンは多くかかります。点数やコストを並べて比べるなら、それぞれがどの設定で出た値なのかを知っておく必要があります。
表のAstraの値は、OpenAIの発表値と同じ数字
Anthropicの表に載っているAstraの値は、OpenAIが自社で発表した値と重なります。FrontierCodeの53.3%、AutomationBenchの41.4%、Humanity's Last Examの57.2%は同じ数字で、Terminal-Bench 4.0の57.9%もOpenAI側の約58%と一致します。
そしてOpenAIは、Astraの公式ベンチマークを原則として最大effort(max)で測ったと明示しています。少なくともこの4項目については、Anthropicの表のAstraの値も、最大effortで出た点数と考えるのが自然です。
「約20%のコスト」はOpus 5.5の既定effortでの比較
一方、Anthropicが「Astraをタスクあたり約20%のコストで上回った」と主張しているFrontierCodeの比較は、Opus 5.5の既定effortでの結果です。Opus 5.5の既定は medium です。
Astra側が最大effortの条件だとすると、この比較は「Opus 5.5の標準の設定」と「Astraのもっとも深い設定」を並べたものになります。Astraのコストが大きく出た理由の一部は、モデルの差ではなく設定の差にあるかもしれません。発表からは両者の条件の細部まで確かめられないので、20%という数字はこの前提つきで読むのが安全です。
Codexで動くAstraの既定は、もっとも軽いlow
実務でもっと影響が大きいのは、道具の既定値です。私たちが2026年9月5日にCodex CLI(0.153.4)で確認したところ、Codex上のAstraの既定effortは low、つまりいちばん軽い設定でした。Claude CodeのOpus 5.5の既定は medium です。
どちらも既定のまま使うと、公式表の点数が出た条件とは違う設定で動いていることになります。特にAstraは、表の点数(最大effort)と既定(low)の開きが大きくなります。「表ではAstraが上だったのに、使ってみると物足りない」と感じたら、モデルの実力を疑う前にeffortを確かめてください。
なお、Codex上のAstraには max のさらに上に ultra という設定がありますが、これは「もっと深く考える」ものではなく、作業を自動で分担させる別の仕組みです。公式表の条件に合わせたいときに、最上位の設定として選ぶものではありません。
乗り換えの実務コスト:Claude CodeとCodexの行き来
単価や点数の差より、実務で効いてくるのは乗り換えの手間です。Opus 5.5は主にClaude Codeから、AstraはCodexやChatGPTから使うことになるため、モデルを替えるとは道具ごと替えることを意味します。
設定や手順の蓄積は、手直しなしには持ち越せない
Claude Codeに書き溜めた指示ファイルやフック、権限の設定は、置き場所や書き方が道具ごとに違うため、Codexへ移すには手直しが要ります。逆方向も同じです。
私たちの社内でも、Claude Code側には業務ごとの手順書やスキルが数多く蓄積されています。これをCodex向けに整え直す手間は、モデルの単価差で取り返せるほど小さくありません。すでに片方で自動化を組んでいるなら、「新しいほうが少し点数が高い」だけで乗り換えるのは割に合いません。
契約と課金が二重になる
両方を使うなら、Claude側とOpenAI側で別々に契約し、別々に利用上限を管理することになります。月額プランを2本持つか、APIキーを2系統持つかのどちらかです。少人数の会社では、この管理の手間も見落とせないコストになります。
APIで2つのモデルを混ぜるときの注意
自社システムからAPIで両方を呼び分ける場合、Opus 5.5には気をつける点があります。Opus 5.5の思考ブロック(回答前の考えの記録)を読めるのはFable 5.1とMythos 5.1だけで、会話の途中で他のモデルに振り替えると、それまでの思考は引き継がれずに続きます。
また、Opus 5.5ではツールの強制指定(tool_choice の any/tool)が使えなくなりました。業務自動化で「必ずこのツールを呼ばせる」作りにしている場合は、Opus 5.5側の書き換えが必要です。このあたりを含め、Opus 5からの変更点は移行ガイドにまとまっています。
判断は自分の仕事で数回試してから
私たちはOpus 5.5の公開直後に、Claude Code v2.1.280上でOpus 5とOpus 5.5に同じ課題(郵便番号を整形するPython関数)を3回ずつ解かせました。同じOpus 5.5・同じ設定でも、所要時間は13.7秒から26.6秒まで開きました。
これはAstraとの比較ではありませんが、教訓はそのまま当てはまります。1回だけ試すと逆の結論が出ることがあるので、自社の代表的な作業を2つか3つ選び、両方のモデルで数回ずつ試してから決めるのが確実です。
試すときは、次の3点を揃えると比較がぶれにくくなります。
- 同じ依頼文を使う:言い回しを変えると、モデルの差なのか依頼の差なのか分からなくなる
- effortの条件を先に決める:Claude CodeのOpus 5.5は
medium、CodexのAstraはlowが既定です。既定同士で比べるのか、同じ段階に揃えて比べるのかを決めてから始める - 時間・出力の量・正しさを分けて記録する:速いが間違う、正しいが長い、といった違いは、1つの点数にまとめると見えなくなる
Claude Codeなら、claude -p --model claude-opus-5-5 --output-format json のように実行すると、回答と一緒に所要時間や出力トークン数が記録されます。私たちの計測もこの方法で行いました。
よくある質問
両方を試すには、何を契約すればよいですか?
Opus 5.5は、claude.aiのPro/Max/Team/Enterpriseか、Anthropic APIで使えます(2026年9月23日時点)。Claude Codeで使う場合はv2.1.280以降が必要です。
Astraは、ChatGPTのPlus/Pro/Business/Enterprise、OpenAI API、Amazon Bedrockで提供されています(OpenAI発表・2026年9月4日時点)。Enterpriseは既定でオフになっていて、管理者の有効化が必要です。Codex CLIで使う場合は、最新版に更新してください。私たちの確認では、古い版のままだと「新しいバージョンが必要」というエラーで止まりました。
どちらもAmazon Bedrockで提供されているので、AWSを使っている会社なら、同じAWS環境から両方を呼び出して比べる方法もあります。Astraの提供プランや仕様の詳細は、こちらにまとめています。
GPT-6 Astraとは|何ができるモデルなのか【完全ガイド】
月額プランで使うなら、単価の差は関係ありませんか?
請求額には直接は響きません。ただし、Claudeの月額プランには5時間ごとの利用上限(有料プランはさらに週単位の上限)があり、トークンを多く使うほど上限に早く届きます。従量課金かどうかに関わらず、少ないトークンで終わるモデルのほうが実務では扱いやすいと言えます。
Anthropicの表だけで判断して大丈夫ですか?
判断の材料にはなりますが、それだけで決めないほうが安全です。比較表の数値はAnthropicの発表値で、独立した評価はまだ出ていません。Astraが上回った2項目を自ら載せている点は誠実ですが、effortの条件も含めて、最後は自社の作業で試した結果で決めてください。
まとめ
- 単価は入出力ともAstraがOpus 5.5の2.5倍(Opus 5.5は2026年9月23日時点、Astraは2026年9月4日時点)
- Anthropicの公式表では、コーディングと知識労働でOpus 5.5が上、業務自動化と科学系のターミナル作業ではAstraが上。数値はAnthropicの表から引いたもので、第三者の再現ではない
- 表のAstraの値はOpenAIの発表値と同じで、OpenAIは原則最大effortで測ったとしている。一方でCodexのAstraの既定はlow、Claude CodeのOpus 5.5はmedium。既定のままでは表の条件と違う
- 「Astraを約20%のコストで上回る」はAnthropicの主張で、Opus 5.5の既定effortでの比較
- Claude CodeとCodexの乗り換えは、設定の手直しと契約の二重化を伴う。点数の小さな差だけで乗り換えない
- 最後は自社の代表的な作業で、effortの条件を決めてから両方を数回ずつ試す
株式会社Fyveは、Claude CodeとCodexの両方を実務で使いながら、道具の選び方と組み込み方を検証しています。新しいモデルが出るたびに乗り換える必要はありませんが、自社の作業で試す手順だけは持っておくと、次のリリースでも迷わずに済みます。
最新AI「4モデル」、実務で比べてみた。
Opus 5.5・Opus 5・Fable 5.1・GPT-6 Astra に同じ5つの仕事を投げた実測(全31ページ)
公式ベンチでは、Opus 5.5 が上位の Fable 5.1 や GPT-6 Astra を多くの項目で上回りました。では実際の仕事ではどうか。LP・CSV集計・営業スライド・3D商品ページ・請求書の5つを4モデルに同じ条件で頼み、時間・費用・出来を全部並べました。正解のある課題は4モデルとも全問正解。差が出たのは、速さと費用と、細かい指示の守り方でした。
- 5つの仕事 × 4モデル=20本の実行記録を、時間と費用まで全件掲載
- 成果物そのものを4つ並べて比較(LP・スライド・回せる3D)
- Opus 5 と同じ作り込みを、Opus 5.5 がどれだけ短く終えたか
- 細かい指示を最後まで守ったのはどれか——仕事別の早見表と判断フローつき
メールアドレス登録で他にも様々な資料を閲覧できます
 +6
PDF 15点・合計400ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。