ChatGPTのData agentとは|社内データを聞く前提

「ChatGPTに、自社の売上データをそのまま聞けたら早いのに」——社内の数字を調べるたびに、担当者に依頼して数日待つ。そんな会社は少なくありません。
結論から言うと、AIに社内データを聞けるようになるかどうかは、モデルが賢いかどうかではなく、どこに繋がるか(接続)・社内の言葉が定義されているか(定義)・接続したアカウントに何が見えるか(権限)の3つで決まります。2026年9月10日にOpenAIが公開した「Data agent」は、まさにこの3つを前提にした作りになっています。
株式会社Fyveは中小企業のAI活用を月額で伴走していますが、この3つは導入前のヒアリングで必ず確認する項目でもあります。この記事では、公開された内容を出所ごとに切り分けたうえで、自社に当てはめるときに何を見ればいいのかを整理します。
結論|「AIに社内データを聞けるか」はモデル選びの話ではない
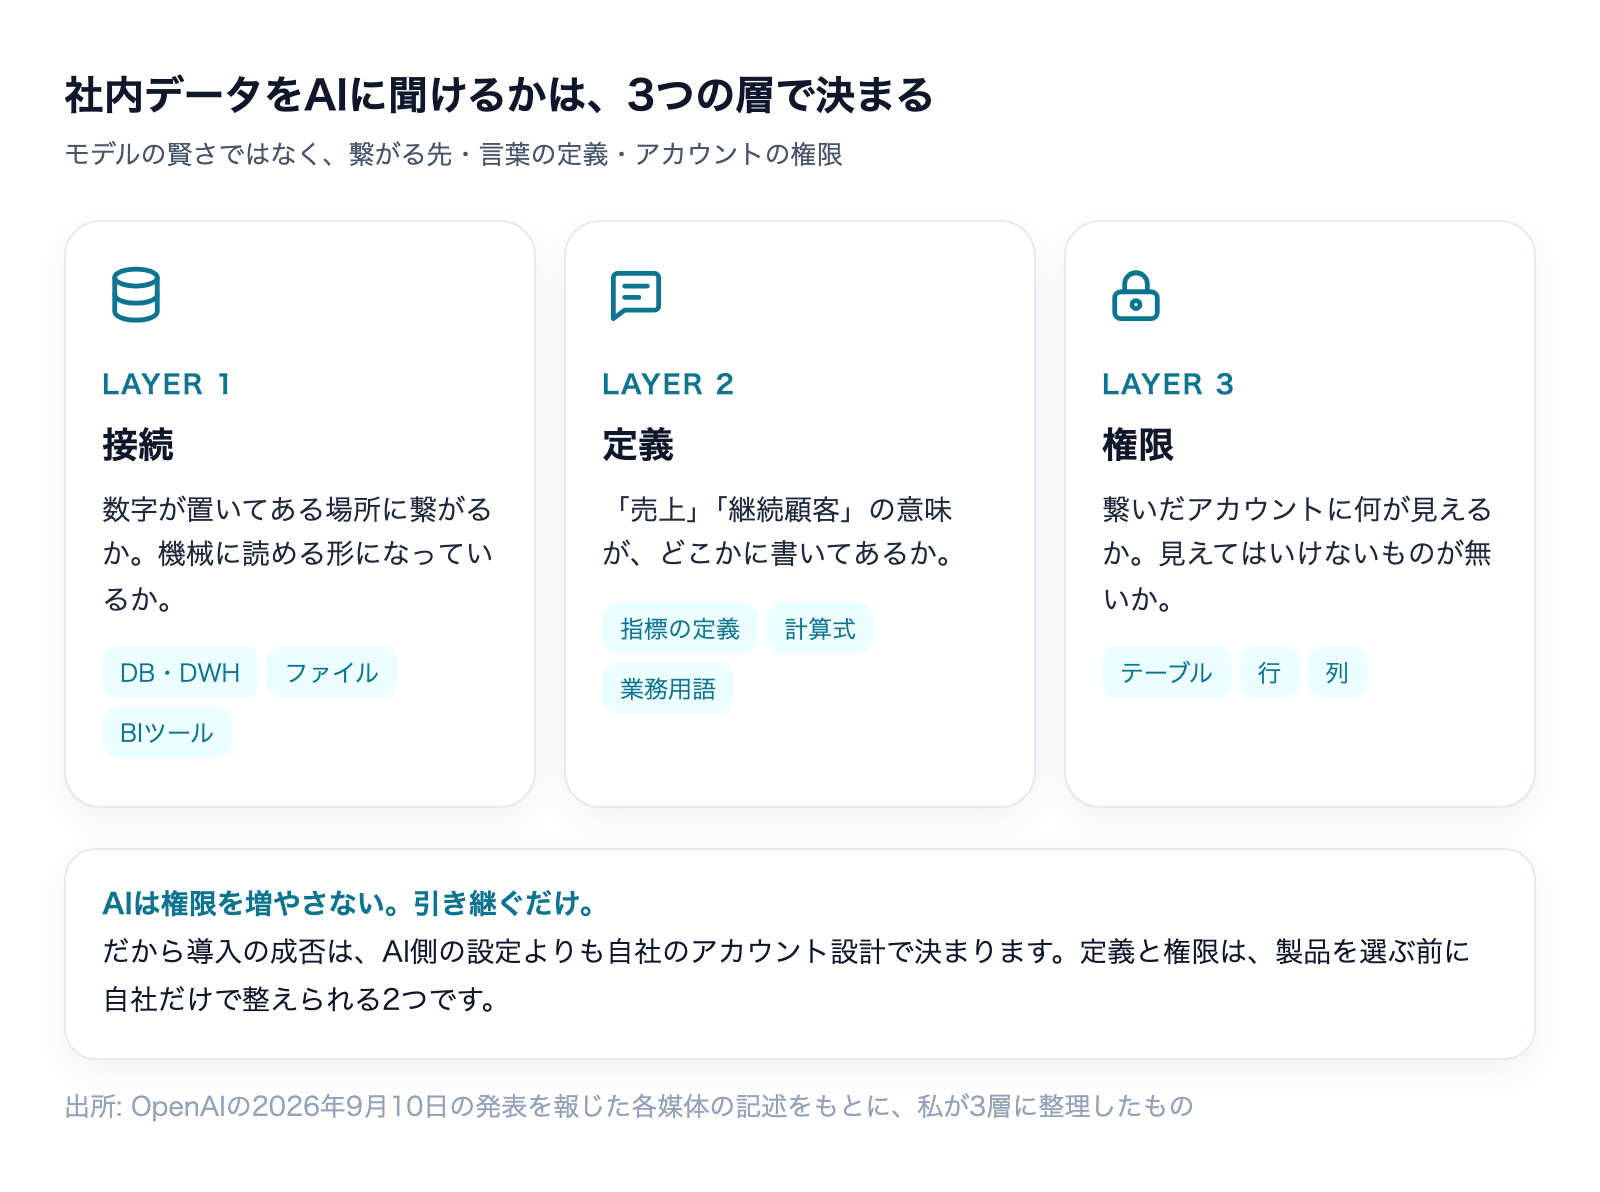
先に答えを置きます。社内データをAIに分析させる仕組みは、次の3つの層が揃って初めて動きます。どれか1つでも欠けると、賢いモデルを選んでも結果は変わりません。
- 接続層——数字が置いてある場所(データベース・ファイル・BIツール)に繋がるか
- 定義層——「売上」「継続顧客」「粗利」といった社内用語の意味が、どこかに書いてあるか
- 権限層——繋いだアカウントに何が見えるか。見えてはいけないものが見えていないか
ここで一番誤解されやすいのが権限層です。AIを入れても、誰かの権限が増えるわけではありません。AIは接続に使ったアカウントの権限をそのまま引き継ぎます。つまり、権限設計が雑な会社は「AIが何も答えられない」か「見せてはいけない数字が出てくる」かの、どちらかに振れます。
この記事の残りは、この3層が9月10日の発表でどう具体化されたのか、そして自社で何を確認すればいいのかを順に見ていきます。
2026年9月10日に何が公開されたのか
この日、OpenAIは性格の違う2つの発表を同時に出しました。片方は社内データ、もう片方は業界データの話です。別物に見えますが、埋めている穴は同じところです。
Data agent|ChatGPT Workに入った社内データ分析
Data agentは、ChatGPT Workに追加された機能です。社内のデータに対して自然言語で質問し、分析結果を対話形式で掘り下げ、そのまま対話型ダッシュボードを作るところまでを1つの流れで行います。データベースへの問い合わせ文(SQL)を自分で書く必要も、分析担当者にレポート作成を依頼して待つ必要もない、という位置づけです。
AiCybrの解説(2026年9月11日公開)によれば、この機能はChatGPT Work内のプラグインディレクトリから導入し、どの接続とどの役割が使えるかをワークスペース管理者が決める設計になっています。会話の中では @Data と呼び出して使います。
ChatGPT for Financial Services|金融版が同梱したもの
もう一方のChatGPT for Financial Servicesは、ChatGPT Workを金融機関向けに仕立て直した製品です。CNBCの取材記事(2026年9月10日公開・9月11日更新)によれば、OpenAIのプロダクト担当バイスプレジデントであるニック・ターリー氏は、発表ブリーフィングで「ChatGPTにアナリストのように調べ、アナリストのように結論を裏づけることを教えている」と説明しています。
設計パートナーはモルガン・スタンレーとエバコアの2社。想定している仕事は、企業リサーチ、財務データの分析、提案資料(ピッチブック)の作成です。CNBCは、これらが従来は投資銀行の新人アナリストが担ってきた領域だと指摘しています。
ここで重要なのは、CNBCが明記している「元になったChatGPT Workとの違い」です。同記事は、違いを①外部データへのネイティブなアクセス ②利用者が既に契約しているデータ購読への自動接続 ③出典を元の開示資料まで辿れる引用機能 ④機微な案件資料に対する管理機能だと書いています。つまりモデルが金融専用に置き換わったわけではありません。
2つは別物に見えて、同じ場所を埋めている
Data agentが埋めるのは「社内の数字にどう繋ぐか」、金融版が埋めるのは「社外の業界データにどう繋ぐか」です。そして両方とも、繋いだ先のデータをどう解釈するか(定義)と、誰に見せるか(権限)をセットで持ち込んでいます。
言い換えると、2026年9月のこの2本は「モデルを賢くする」側の発表ではなく、「モデルに何を読ませ、誰に見せるかを決める」側の発表でした。自社に当てはめるときも、見るべきはそこです。
接続層|どこに繋がるのかを先に見る
接続層は一番わかりやすい層です。「自社の数字が置いてある場所」に、その道具が繋がるかどうか。ここが合わないと、他がどれだけ良くても検討の余地がありません。
名前が挙がっている接続先
AiCybrの解説は、OpenAIの公開資料とヘルプドキュメントをもとに、接続先を層ごとに整理しています。同記事が挙げている内容を表にすると次のとおりです。
層 | 挙がっている名前 | 役割 |
|---|---|---|
データウェアハウス・データベース | Amazon Redshift/Google BigQuery/ClickHouse/Databricks/MongoDB/Snowflake | 業務データ・分析用データへの問い合わせ |
監視データ | Datadog | アプリ・インフラの計測値を分析に持ち込む |
ファイル・文書 | Google Drive/SharePoint | 表に入っていない背景情報を足す |
意味・文脈の層 | Databricks Genie Ontology/dbt/GitHub/既存のBIダッシュボード | 社内の定義・計算式・データ同士の関係を供給する |
BI・ダッシュボード | Omni/Oracle BI/Power BI/Sigma/Tableau/ThoughtSpot | 既存のBI運用の中で作成・確認・更新する |
同記事は、利用できる接続の組み合わせはワークスペースによって変わること、また各データソース用のプラグインを個別に有効化しないとそのサービスは分析できないことも書き添えています。
中小企業は、たいていここで一度つまずく
この一覧を見て気づくのは、上4つがほぼ「データ基盤を持っている会社」向けだということです。SnowflakeやBigQueryを運用している中小企業は、正直それほど多くありません。
では関係ない話かというと、そうでもありません。ファイル・文書の層にGoogle DriveとSharePointが入っているからです。多くの中小企業にとって、数字が実際に置いてある場所はデータウェアハウスではなく、クラウドストレージの中のスプレッドシートとExcelです。
ただし、ここには落とし穴があります。データウェアハウスのテーブルは「どの列が何なのか」が決まっていますが、手作りのスプレッドシートは同じシートの中に集計行と明細行が混ざり、列の意味が途中から変わることが珍しくありません。人間は見れば分かりますが、機械にとっては別の表です。
私が見てきた範囲では、AIに数字を読ませる前の作業のうち、かなりの部分がこの「表を表の形に戻す」工程でした。接続層の検討は、ツールが繋がるかどうかの前に、自社の数字が機械に読める形で置かれているかから始めたほうが早いです。
定義層|「今月の売上」が社内で割れていると、答えも割れる
接続できたとして、次に効くのが定義層です。ここが今回の発表でいちばん実務的だと感じた部分でした。
AIは「意味」をどこから読むのか
AiCybrの解説によれば、Data agentは質問を解釈するときに、指標の定義・独自の計算式・データ同士の関係・社内の業務用語を、dbt、Databricks Genie Ontology、Snowflake Horizon、GitHub、既存のBIダッシュボードといった社内に既にある場所から読み取れるとされています。
これは地味に見えて、決定的な設計です。「継続顧客」「受注」「粗利」といった言葉は、同じ会社の中でも部署によって指すものが違います。テーブル名と列名だけを見て意味を推測させると、AIはもっともらしいけれど自社の定義と違う数字を出します。定義が書いてある場所を読ませれば、そこは防げます。
同記事はその裏返しも指摘しています。定義が矛盾していたり、古い設定が残っていたり、ダッシュボードごとに計算がバラバラだったりすると、その矛盾はそのまま分析結果に流れ込む、と。モデルが優秀でも関係ありません。
私の会社で実際に割れていた数字
これは他人事ではありませんでした。私は自社の記事制作を自動処理で回していて、毎日の結果を記録に残しています。あるとき「今月は何本公開したか」を集計しようとして、数が合わないことに気づきました。
原因は単純で、「公開した本数」の定義が2つあったからです。片方は「記事として書き上がった本数」、もう片方は「実際に公開まで到達した本数」。品質検査で差し戻して保留にしたものを、前者は数え、後者は数えません。どちらも間違っていないので、数字だけ見ても矛盾に気づけません。
このとき直したのはツールではなく、「公開本数とはこれを指す」という一行でした。定義層というのは、要するにこの一行がどこかに書いてあるかどうかの話です。
定義が無い会社が最初にやること
いきなりdbtのようなツールを導入する必要はありません。順番としては、次の3つで十分に前に進みます。
- よく聞かれる数字を5つ書き出す——「今月の売上」「継続している客数」など、社内で毎月話題に出るものだけでかまいません
- それぞれの定義を1行で書く——「売上=請求書を発行した日で計上。キャンセル分は除く」のように、境界だけ決めます
- その5行を、数字と同じ場所に置く——別のツールに入れず、スプレッドシートの隣のシートで構いません
AIに読ませるためだけの作業に見えますが、これは人間同士の会議でも効きます。実際、定義を書き出す過程で「うちはそこが揃っていなかった」と分かることのほうが多いくらいです。
AIを入れても成果が変わらない、という悩みの構造そのものについては、別の記事で詳しく書いています。
権限層|AIは権限を増やさない。引き継ぐだけ
3つ目が権限層です。今回の発表で、私がもっとも注目したのはここでした。
テーブル・行・列の制限がそのまま効く
AiCybrの解説によれば、Data agent経由の問い合わせは接続したアカウントに既に設定されているテーブル単位・行単位・列単位の権限をそのまま適用するとされています。加えて、どのデータ接続を使えるようにするか、どの役割に使わせるかは、ワークスペース管理者が決めます。
ここを読み違えると危険です。「AIを入れたら全社の数字が見えるようになる」のではありません。見えるのは、繋いだアカウントに元から見えていたものだけです。
つまり導入の成否は、AI側の設定よりも自社のアカウント設計で決まります。同記事も、実効的なアクセス境界は問い合わせに使う接続のアカウントが持つ権限で決まると書き、財務・顧客・従業員・規制対象のデータを含む環境では、広く展開する前に各接続を既存のデータガバナンス上の役割に対応づけるべきだと指摘しています。
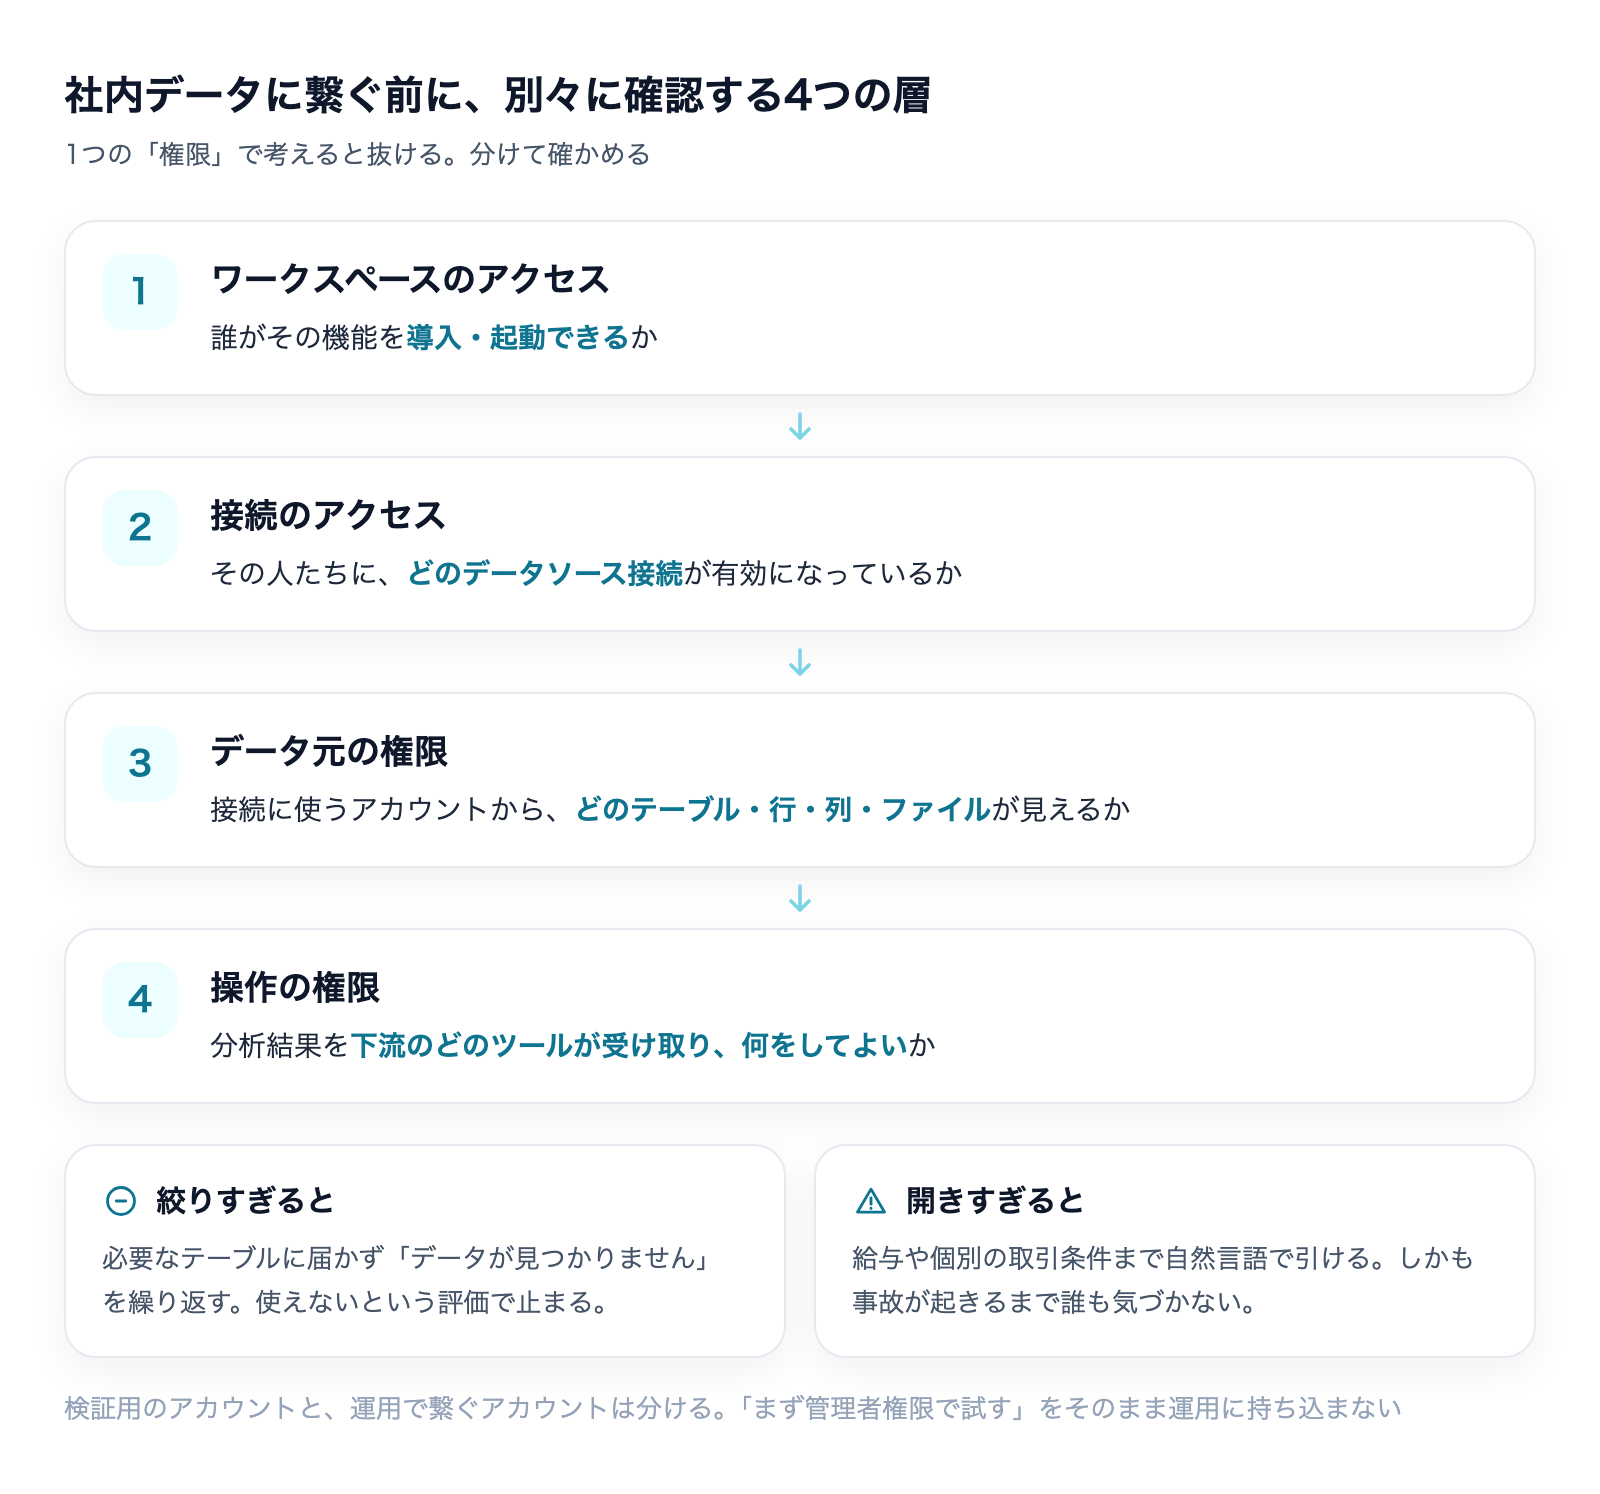
確認すべきは4つの層
同記事は、展開前に別々に確認すべき層として次の4つを挙げています。この分け方は、Data agentに限らず社内データに繋ぐAI全般で使えます。
- ワークスペースのアクセス——誰がその機能を導入・起動できるか
- 接続のアクセス——その人たちに、どのデータソース接続が有効になっているか
- データ元の権限——接続に使うアカウントから、どのテーブル・行・列・ファイル・ダッシュボードが見えるか
- 操作の権限——分析結果を、下流のどのツールが受け取り、何をしてよいか
「答えられない」と「見えてはいけないものが出る」の分かれ目
権限層の話は、実際には2つの失敗として現れます。
1つは何も答えられないパターン。慎重に権限を絞りすぎたアカウントで繋ぐと、AIは必要なテーブルに届かず、「データが見つかりません」を繰り返します。使えないという評価になって、そこで止まります。
もう1つは見えてはいけないものが出るパターン。管理部門のアカウントで繋いで全社に開放すると、給与や個別の取引条件まで自然言語で引ける状態になります。しかもこちらは、事故が起きるまで誰も気づきません。
だから「まず管理者権限で試す」は、検証としては自然でも、そのまま運用に持ち込んではいけない手順です。検証用のアカウントと、運用で繋ぐアカウントは分ける。これは今回の発表に関係なく、社内データにAIを繋ぐときの基本になります。
中小企業がAI導入前に押さえるべきセキュリティの全体像は、こちらにまとめています。
業種版は何を売っているのか|金融版を分解する
ここまでの3層を踏まえると、「業種特化AI」と呼ばれるものの正体が見えてきます。ChatGPT for Financial Servicesを分解してみます。
①同梱されたデータ
TestingCatalog(2026年9月11日公開)とPulse 2.0の記事によれば、この製品にはDaloopa、PitchBook、LSEG News、Crunchbaseのデータセットが組み込まれており、決算説明の書き起こし、財務諸表、企業のファンダメンタルズ、未上場企業の情報をカバーするとされています。利用する側は個別に契約交渉をしたりコネクタを設定したりせずに、すぐ使い始められる、というのが売り文句です。
なおこの点は媒体間で記述が割れています。CNBC、TestingCatalog、Pulse 2.0はCrunchbaseを含む4社を挙げていますが、Unite.AIの記事はDaloopa、PitchBook、LSEG Newsの3社しか挙げていません。Pulse 2.0はCrunchbase CEOのコメントを引用しているため、ここでは4社として扱っています。契約前には公式の案内で確認してください。
既にデータを購読している企業向けには、S&P Capital IQ、LSEG、MSCI、Dow Jones Factiva、Moody'sとの間で、ChatGPTのサインインで利用者を識別して既存の購読権限を自動で有効にする仕組みを進めているとされています。コネクタ全体では50以上あり、Datasite、Box、Preqin、Intappなどが含まれます。
②出典を辿れること
Unite.AIの記事は、OpenAIがデータを自社のインフラ上で索引付け・保持しており、それによって細かい単位での引用が可能になっていると伝えています。具体例として挙げられているのは、調整後EBITDAの数字について、その裏にある調整過程や注記を確認し、どのコストが除外されたのかを理解したうえで、評価にどう使うかを判断する、という使い方です。
これは業務用AIの評価軸として、地味ですが重要です。数字が出てくることと、その数字の出どころを辿れることは別だからです。辿れない数字は、そのまま社外に出す資料には使えません。
③情報の壁と管理機能
Pulse 2.0の記事によれば、この製品はSAML SSO、SCIMによるユーザー管理、役割ベースのアクセス制御、ワークスペースの保持期間設定、コンプライアンスログの書き出し、そしてワークスペースを分けることによる情報障壁といった機能を備えます。投入した業務データは既定ではモデルの学習に使われず、保存時・通信時とも暗号化されるとされています。
案件情報が部門をまたいで漏れてはいけない業界の要求が、そのまま製品機能になっている形です。
④モデルは共通
そして、ここが最初に書いた話に戻ります。Unite.AIの記事によれば、モデルは製品に組み込まれたGPT-6 Astraで、新しいモデルが出れば順次利用できるようになるとされています。金融専用のモデルが作られたわけではありません。
同記事はOpenAIの主張として、米国財務省の月報にある複雑な財務表・図表・脚注を横断して情報を探し分析できるかを測るOfficeQA Proというベンチマークで、GPT-6 Astraが69.9%、GPT-5.6 Solが60.2%だったと伝えています。この数字はOpenAI自身の発表によるものである点に注意してください。
整理すると、業種版で買っているものの大半はデータの利用権・出典の追跡・統制の仕組みであって、モデルの賢さではありません。Anthropicが金融向けに出している同種のソリューションを分解した記事もありますので、あわせてどうぞ。
中小企業が真似できるのはどこか
投資銀行向けの製品そのものは、ほとんどの読者にとって無関係です。しかし構造は流用できます。自社の業界にまだ「業種版」が来ていない会社がやることは、次の3つに整理できます。
- よく使う外部データを1か所に置く——業界統計、仕入先の価格表、公的な調査資料。毎回探しているなら、それは同梱データが解いている問題と同じです
- 出典を残す形で保存する——PDFを保存し、どのページから取ったかを書く。要約だけ残すと、後から辿れません
- 見せない範囲を先に決める——全社に開くもの、経営だけが見るものを分ける。これは製品の機能ではなく、自社で決めることです
私が無人運用で先に踏んだこと|権限は指示では守られない
ここからは、私自身が自動処理を運用していて学んだことです。今回の発表を読んだとき、既視感があったのはこの部分でした。
書いてよい場所を、指示ではなく機械で区切った
私は毎日、人が見ていない時間帯にAIへ定型業務を実行させています。最初は「この範囲だけ触ってください」と指示文に書いていました。これは守られませんでした。悪意があるわけではなく、作業の流れで自然に範囲外へ手が伸びるだけです。
解決したのは、指示を丁寧にしたときではなく、実行の外側に機械的な壁を置いたときでした。決められた場所以外への変更は、実行後にまとめて破棄する。指示文を読む主体と、範囲を強制する主体を分けたわけです。
Data agentが「接続アカウントの権限をそのまま適用する」という設計になっているのは、まったく同じ発想です。AIに何をしてよいかを教えるのではなく、できないようにしておく。
既存の成果物に触れる道具を、1つに絞った
もう1つ効いたのが、読むのは自由、書くのは限定という分け方です。私の運用では、既に公開してある成果物に手を加える操作を、専用の道具1つだけに限定しています。その道具は、追加した部分を取り除いたら元の内容と完全に一致するかを機械的に検証し、一致しなければ自動で元に戻します。
なぜそこまでするかというと、既存の成果物が壊れても、すぐには気づけないからです。数字が落ちて初めて分かる種類の壊れ方は、後から監査しても救えません。だから人の確認を挟まない代わりに、機械的な検証を通した経路以外を塞ぎました。
社内データに繋ぐAIでも、同じ問いが出てきます。読み取り専用の接続で始められないか。書き込みまで許すなら、それは誰がどう検証するのか。先ほどの「操作の権限」という4層目は、ここを指しています。
出典を辿れる形で残していないと、検査が通らない
3つ目は定義層と出典の話です。私の社内には、成果物を作る工程とは別に、内容を点検する工程があります。この点検役は、手元に実体として残っているものしか確認できません。
以前、参照した資料をその場で読んで内容だけ使い、元の資料を保存していなかったことがありました。書かれている内容は正しかったのですが、点検の段階で「裏づけが確認できない」と判断され、そこで止まりました。手続きとしては点検役が正しいので、こちらが運用を変えるしかありません。
以来、参照した資料は先に手元へ保存してから書くようにしています。金融版の「引用から元の開示資料まで辿れる」という機能が売りになる理由は、実感としてよく分かります。正しいことと、正しさを示せることは別です。
今日できる3つの確認
ここまでの内容を、明日からの動作に落とします。ツールを契約する前に、社内で確認できることです。
①数字がどこに置いてあるかを書き出す
売上、顧客、在庫、勤怠。それぞれが「どのシステムの、どこ」にあるかを1枚にします。この段階で、同じ数字が3か所にあって少しずつ違う、という状況が見つかることがよくあります。見つかったら、それは接続の問題ではなく運用の問題です。
②よく聞かれる数字の定義を5行書く
前述のとおりです。ツール導入の有無にかかわらず効きます。5行で足りない会社は、まず5行に絞るところから始めてください。
③「AIに繋ぐアカウント」を仮に1つ決めて、何が見えるか確かめる
これが一番早い現実確認です。実際に繋ぐ前に、そのアカウントでログインして、見えるものを眺めてみてください。
- 必要な数字が見えないなら、接続しても答えは返りません
- 給与や個人情報まで見えるなら、そのアカウントで全社に開いてはいけません
この2つの間に収まるアカウントを作れるかどうかが、社内データAIの導入可否をほぼ決めます。製品比較より先に、ここを確認したほうが早いというのが私の結論です。
よくある質問
Data agentは日本の中小企業でも使えますか
Data agentはChatGPT Workの機能として提供されるもので、ワークスペース管理者が接続と役割を設定する前提です。まず自社が対象のプランを利用しているか、必要なデータソース用のプラグインが有効化できるかを確認してください。提供状況や対象範囲は変わるため、最新の公式案内での確認をおすすめします。
データウェアハウスを持っていなくても始められますか
接続先の一覧にはGoogle DriveとSharePointのファイル・文書も含まれています。ただし本文で触れたとおり、手作りの表は機械から見ると読みにくい形をしていることが多く、そこの整理が先になります。データ基盤の導入より、まずは表の形を整えるほうが費用対効果は高いです。
AIに繋いだら、社員に見えるデータが増えますか
増えません。AiCybrの解説によれば、問い合わせは接続したアカウントの既存の権限(テーブル・行・列)に従います。見える範囲を広げたいなら、それはAI側ではなくデータ側の権限を変える作業になります。逆に言えば、権限を整理しないままAIを繋ぐと、既存の雑さがそのまま表に出ます。
ChatGPT for Financial Servicesは日本の金融機関も使えますか
各媒体は「対象となる金融機関が利用可能」と伝えており、OpenAIは関心のある企業に問い合わせるよう案内しているとされています。対象要件は公開資料からは読み取れないため、利用可否は直接の確認が必要です。
業種特化版が出るまで待ったほうがいいですか
待っている間にできることが多い、というのがこの記事の趣旨です。業種版が同梱しているのはデータ・出典の追跡・統制であり、そのうち定義と権限は自社でしか整えられません。業種版が来た日に使い始められるかどうかは、その準備で決まります。
今回の数字はどこまで信頼できますか
この記事で引用した内容は、OpenAIの発表を報じた各媒体の記述に基づいています。OpenAIの公式発表ページは執筆時点で直接取得できなかったため、複数媒体で一致する記述を優先し、割れている箇所(データ提供社の数)はその旨を明記しました。ベンチマークの数値はOpenAI自身の発表によるものです。導入判断に使う数字は、公式の最新案内で確認してください。
まとめ
2026年9月10日に公開されたData agentとChatGPT for Financial Servicesは、どちらも「AIをもっと賢くする」発表ではありませんでした。どこに繋ぎ、どの定義で解釈し、誰に見せるか——業務でAIを使うときに効くのは、結局この3層です。
- 接続層:数字が機械に読める形で置いてあるか。手作りの表はそのままでは読めない
- 定義層:社内用語の意味がどこかに書いてあるか。書いていないと、もっともらしい別の数字が出る
- 権限層:AIは権限を増やさず引き継ぐ。繋ぐアカウントの設計が導入の成否を決める
このうち定義と権限は、製品を選ぶ前に自社だけで進められます。むしろ、そこが整っていない状態でどの製品を比べても、比較の結論は変わりません。
株式会社Fyveでは、この3層のどこで止まっているかを業務の棚卸しから特定し、順番を決めるところから伴走しています。自社の数字をAIに聞ける状態にしたいと考えている方は、まず上の「今日できる3つの確認」から試してみてください。
参考にした情報源
- CNBC「OpenAI targets work of Wall Street junior bankers with new ChatGPT for Financial Services」(2026年9月10日公開・9月11日更新)
- Unite.AI「OpenAI Launches ChatGPT for Financial Services With Built-In Data」(2026年9月10日公開)
- TestingCatalog「OpenAI launches ChatGPT for Financial Services」(2026年9月11日公開)
- Pulse 2.0「OpenAI Launches ChatGPT For Financial Services With GPT-6 Astra And Built-In Premium Data」
- AiCybr「OpenAI Data Agent for ChatGPT Work: Data Sources, Permissions, BI Integrations and Setup」(2026年9月11日公開)
Workにしかできない仕事は、2つだけ

同じ仕事をChatにも投げた結果と、Work固有に残った2つ(全26ページ)
Workに投げていた仕事、Chatでも同じものが返ってきます。見積の比較表、提案スライド、アンケートの集計レポート——3つとも同じ指示文で両方に出して、時間を測りました。Work固有だとよく言われる5つも、公式ドキュメントと実機で1つずつ確かめています。両方に課金して毎日どちらも使っている立場から、測った数字をそのまま出します。
- 3つの仕事を両方に投げた記録——出力・かかった時間・直した箇所
- 定期実行は普通のチャットから登録できる(実機で確認)
- Workを選ぶ理由になった2つと、ならなかった3つ
- 自分の仕事で15分で確かめる手順。この資料は信じなくて大丈夫です
メールアドレス登録で他にも様々な資料を閲覧できます
 +4
PDF 13点・合計358ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。