GitHubの障害を確認する方法|push失敗時の切り分け

「git pushが通らない」「Actionsが動き出さない」「プルリクエストの画面が開かない」——GitHubが止まったのか、自分の手元がおかしいのか分からないまま、時間だけが過ぎていく。GitHubの障害を疑ったとき、誰もがこの不安を抱えます。
結論から言うと、GitHubの障害は公式の稼働状況ページ githubstatus.com で確認でき、正常と出ているのに動かないときは「SSHの接続テスト → 443番ポート経由 → HTTPSへの切り替え」の順で自分側を切り分けられます。ただし、このページは「上の欄が全部緑でも、下に障害の掲示が出ている」ことがあり、数日後に後付けで掲示される障害もあります。読み方を知らないと見落とします。
株式会社Fyveは、AIに任せた定期の仕事を毎日十数本、無人で回しており、そのすべてがGitHubとのやり取りから始まります。この記事では、2026年8〜10月に実際に掲示された障害の記録と、私たちのジョブで実際に起きたpushの失敗と、そこから見つけた穴をもとに、確認の手順と止まらないための備えをまとめます。
結論:GitHubの障害かどうかは3ステップで確認する
先に手順だけを並べます。詳しい読み方は後の節で説明します。
- githubstatus.com を開く:上の各欄の色だけでなく、その下の掲示(インシデント)と「Past Incidents」まで見る。データ所在地を選んだ企業向けのGitHub(GHE.com)を使っている会社は、地域別の別ページを見る
- 公式が正常なら、自分側を順に見る:
ssh -T git@github.comで接続を確かめる → だめなら443番ポート経由(ssh.github.com)を試す → それでもだめならHTTPSに切り替える - 次に備えて「先に気づく」仕組みを入れる:稼働状況ページの更新を購読し、無人の処理はpushの失敗を「失敗」として知らせるようにする
GitHubは1つのサービスに見えますが、稼働状況ページでは「Git Operations(clone・pull・push)」「Actions」「Pull Requests」など12の欄に分かれています。どの欄が止まったかで、困ることと取れる手が変わります。まず、最近実際に起きたことから見ていきます。
2026年8〜10月に実際に起きたGitHubの障害
githubstatus.com が公開している掲示の一覧(API)から、2026年10月20日時点で取得できた直近50件(8月5日〜10月20日)を読みました。以下の時刻はすべて日本時間に直しています。
10月8日未明:書き込みだけが合計約19分止まった(読み込みは通った)
2026年10月8日0時6分〜0時16分ごろと、1時52分〜2時1分ごろの2回、GitHub全体で「データを保存・変更する操作」が失敗しました。GitHubの事後報告によると、2回は同じ原因で、合計は約19分です。対象はGit操作、プルリクエスト、Issue、Actions、API、Webhook、サインインと認証、Copilotなど広範囲に及びました。
この報告で大事なのは次の一文です。「データの読み込みはおおむね影響を受けなかった」。つまり、cloneやfetch、画面の閲覧はできるのに、pushやマージ、Issueの作成だけが失敗する、という状態です。報告では、1回目の最中にGit認証の要求の最大26%、Actionsのワークフロー実行の17%が基盤側のエラーで失敗したとしています。データの消失は無く、復旧後に再試行した操作は成功したと書かれています。
「見えているのに書けない」障害は、自分の設定を疑いやすいのが厄介なところです。pushだけが失敗するときほど、先に稼働状況ページを見る価値があります。
10月20日未明:Actions・Pages・Webhookの遅れ
直近では2026年10月20日0時49分〜1時56分に、Actions、Pages、Webhookの性能低下が掲示されました。掲示の文面は「ワークフローの処理、サイトのビルド、Webhookの配信が遅れる可能性がある」というもので、0時56分の時点で調査中、1時30分に「回復が見えてきた」、1時56分に解決となっています。
この掲示は、一覧の上では影響度が最も重い「critical」として記録されています。一方で、各欄の状態は最後まで「degraded performance(性能低下)」のままで、「major outage(重大な停止)」にはなっていません。掲示全体の影響度と、各欄の色は別々に付けられているということです(読み方は後の節で説明します)。
8月21日夜:SSHだけが落ち、HTTPSは無事だった(掲示は3日後)
2026年8月21日23時0分〜23時7分、SSH経由のGit操作が落ちました。事後報告によると、ピーク時にはSSHでのGit操作の成功が95%以上減り、約4分間はほとんどの利用者がSSHでclone・fetch・pushできない状態でした。HTTPS経由のGit操作は影響を受けていません。原因は負荷分散の設定変更が引き起こした不具合で、設定を戻して収まっています。
この障害の掲示が出たのは、3日後の8月24日16時19分です。最初から「解決済み」の状態で一覧に加わりました。障害の最中に稼働状況ページを見ても、何も出ていなかったことになります。同じように後から足される掲示は、名前に「[Retroactive](さかのぼって掲示)」と付くこともあり、直近50件のうち2件がそうでした。
8月17日夜〜18日朝:7時間47分の長い障害
2026年8月17日22時28分〜18日6時15分(7時間47分)には、Issue、プルリクエスト、API、Actions、Copilotでエラーと遅延が増えました。ピーク時のWeb・APIのエラー率は約20%、アーカイブとファイル単体のダウンロードは約50%です。原因は米国中部のデータセンターの負荷分散装置が、新しいピークの通信量であふれたことでした。
この報告には、もう1つ見逃せない記述があります。再試行の仕組みが負荷を増やし、回復を遅らせたという点です。VS Code側の再試行の不具合で通信が約10倍に増え、Copilotの認証の処理は通常の毎秒7,000〜9,000件から7万〜10万件に跳ね上がったとされています。後の「備え」の節で、この教訓を使います。
10月だけで12件、直近50件は約2か月半
直近50件は8月5日〜10月20日の約2か月半に収まっていました。10月は20日までに12件で、影響度の内訳は critical 5件・major 1件・minor 6件です。欄別に数えると、掲示に紐づいた回数が多いのは Actions(12回)、Pull Requests(11回)、Copilot AI Model Providers(8回)でした。
多くはActionsやプルリクエストの部分的な遅れで、Git操作そのものが止まる掲示は4件だけです。「GitHubが落ちた」と感じたときでも、実際に止まっているのは一部の機能であることが多い、と覚えておくと切り分けが早くなります。
① githubstatus.com の読み方
ここからは、確認の1つ目である稼働状況ページの読み方です。
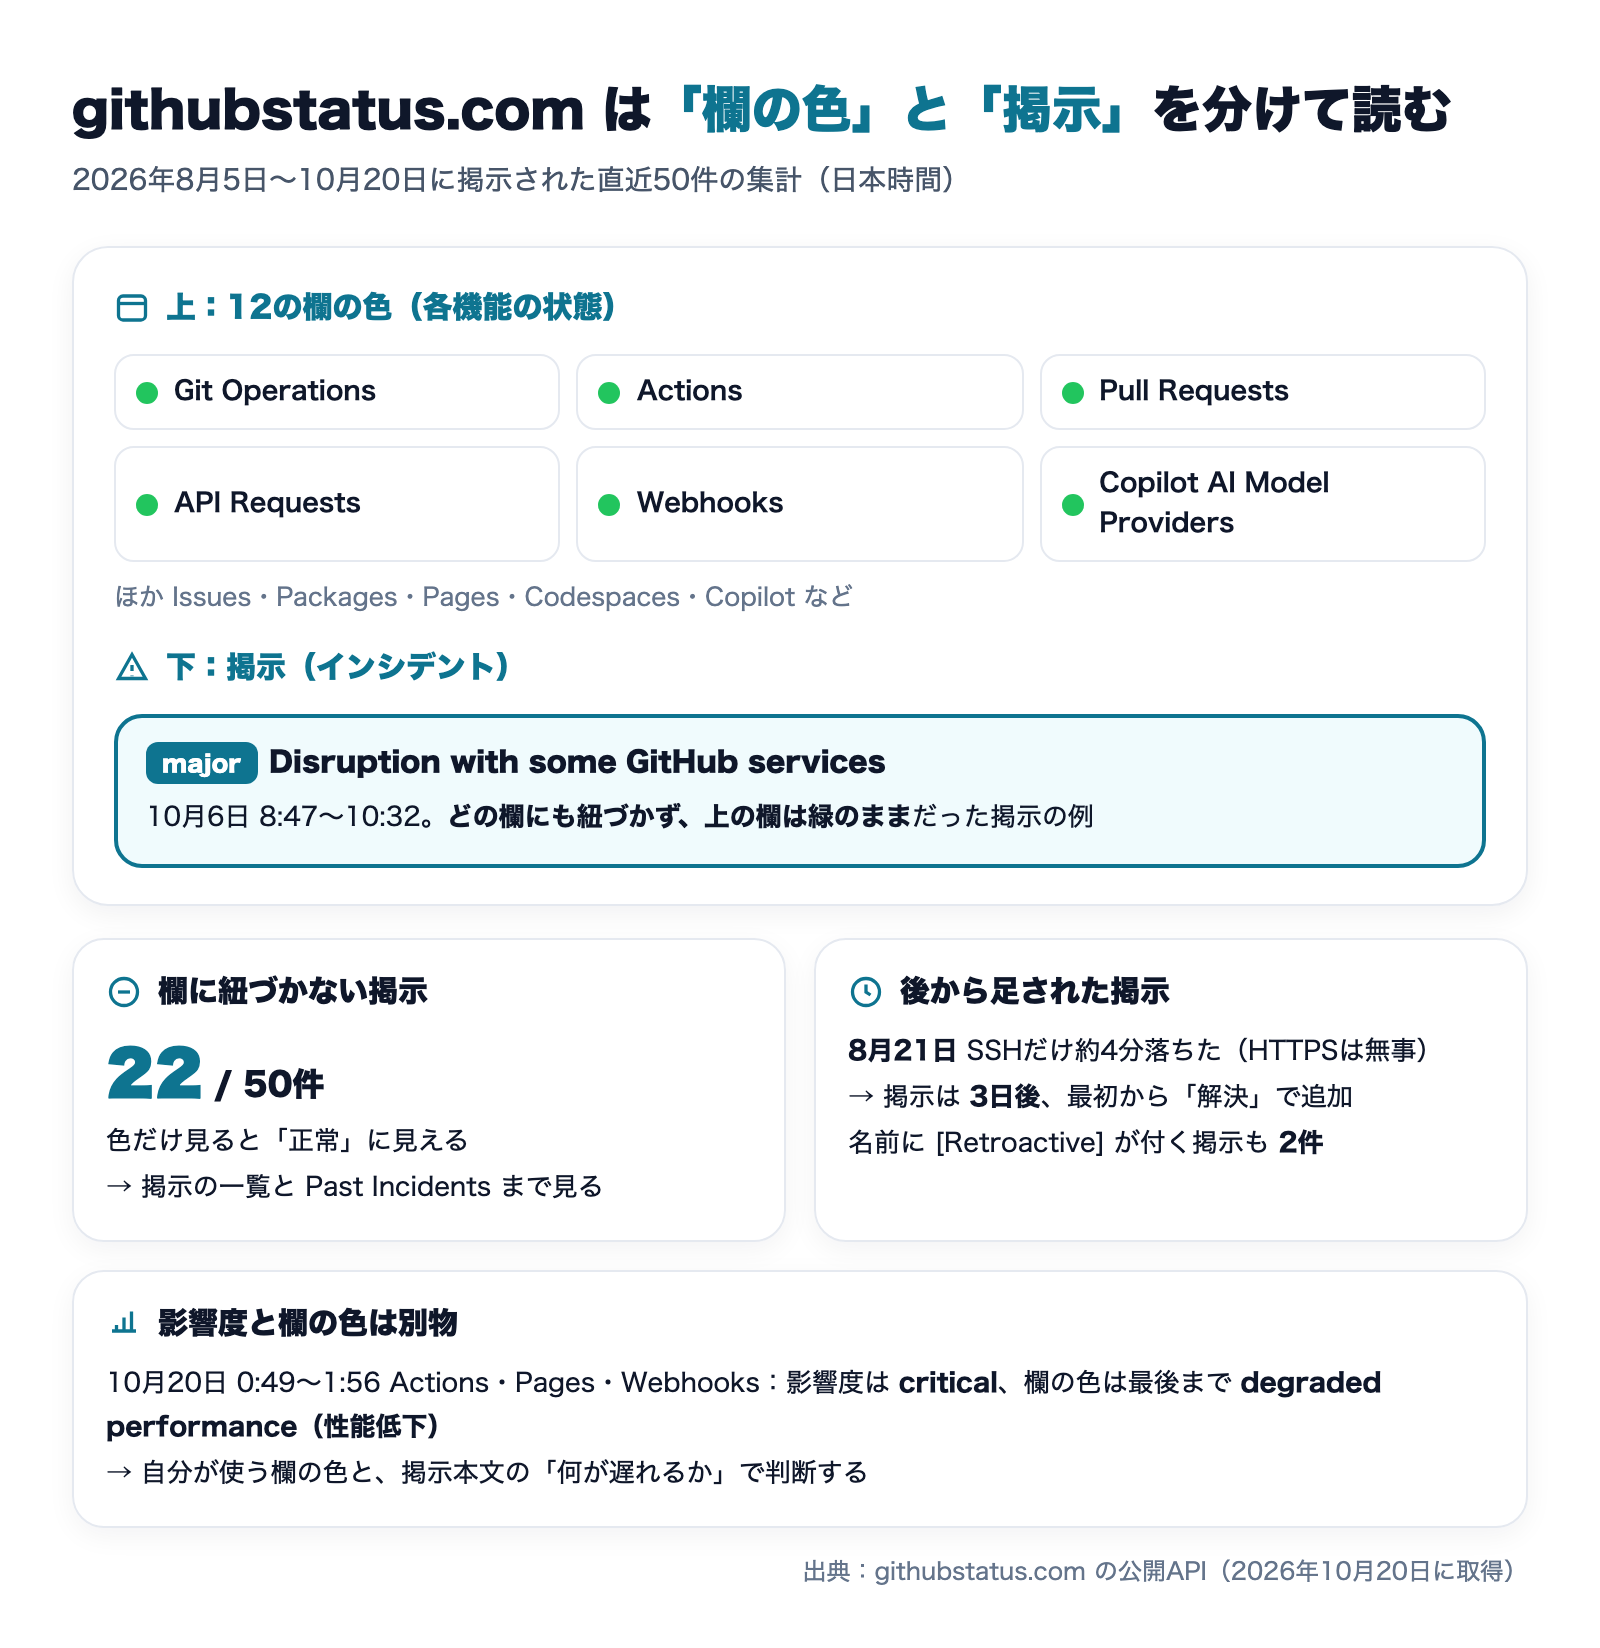
12の欄と、それぞれが止まると困ること
2026年11月7日時点でも、githubstatus.com には次の12の欄があります(説明は公式の各欄の説明を訳したもの。Copilotの2欄は公式の説明が無いため、欄名から読み取った補足です)。
欄の名前 | 中身 | 止まると困ること |
|---|---|---|
Git Operations | clone・pull・pushなどのGit操作 | コードの取得と送信。CIの最初の取得も失敗する |
Webhooks | 出来事を外部へ知らせるHTTPの呼び出し | 外部のCI・チャット通知・自動デプロイが動かない |
API Requests | GitHubのAPIへの要求 | gh コマンドや連携ツール、ボットが失敗する |
Issues | Issueの操作 | タスク管理の起票・更新 |
Pull Requests | プルリクエストの操作 | レビューとマージ |
Actions | ワークフローの実行基盤 | テスト・ビルド・定期実行が遅れる、失敗する |
Packages | GitHub PackagesのAPIとWebhook | パッケージの取得・公開 |
Pages | Pagesのビルドと配信の仕組み | 静的サイトの更新が反映されない |
Codespaces | Codespacesの起動と計算資源 | ブラウザの開発環境が立ち上がらない |
Copilot | (公式の説明なし) | Copilot全般の不調 |
Copilot AI Model Providers | (公式の説明なし。欄名のとおり、Copilotが呼び出す外部のAIモデルの提供元と読めます) | 特定のモデルだけがエラーになる |
(案内の行) | 「詳しくは www.githubstatus.com へ」という案内 | — |
「Copilot AI Model Providers」が独立した欄になっている点は、AIを使う人には特に大事です。直近50件では、この欄に紐づく掲示が8回あり、「Copilotが提供するOpenAIのモデルでエラー率が上昇」「Gemini 3.8 Flashの性能低下」のように、特定のモデルだけが名指しされていました。Copilotが不調なときは、モデルを切り替えるだけで続けられる場合があります。
上の欄が全部緑でも、掲示が出ていることがある
稼働状況ページを開いて、上の欄が全部緑なら「正常」と判断しがちです。ところが直近50件のうち22件は、どの欄にも紐づかない掲示でした。たとえば2026年10月6日8時47分〜10時32分の「Disruption with some GitHub services(一部のGitHubサービスの障害)」は影響度 major ですが、欄の色は変わっていません。
だから、色だけで判断せず、欄の下に出る掲示の一覧と「Past Incidents(過去の掲示)」まで目を通すのが確実です。
掲示の段階と、影響度の読み方
掲示は段階ごとに更新が積み重なります。直近50件で使われていた段階は次の3つでした。
- Investigating(調査中):報告を受けて調べている。直近50件では更新の大半(240回)がこの段階
- Monitoring(監視中):対策を入れて、回復を見守っている。この段階でも一部の遅れが残っていることがある
- Resolved(解決):解決。後日、原因と再発防止策の報告がこの欄に追記されることがある(この記事で読んだ10月7日・8月17日・8月21日・10月19日(UTC)の障害は、いずれも解決後に追記されていました)
影響度は掲示全体に付く印で、重い順に critical・major・minor・none です。各欄の色は別に付き、「operational(正常)」「degraded performance(性能低下)」「partial outage(一部停止)」「major outage(重大な停止)」の4段階です。前の節で見た10月20日の掲示のように、影響度が critical でも欄は「性能低下」ということがあります。自分の作業が止まるかどうかは、影響度より「自分が使っている欄」の色と、掲示本文の「何が遅れるか」の一文で判断します。
先に気づく:更新の購読とフィード
稼働状況ページの「Subscribe to Updates」から、掲示の更新をメールなどで受け取れます。フィードも用意されており、https://www.githubstatus.com/history.rss を読み込めば、使っているチャットやRSSリーダーに流せます。
プログラムから確かめたい場合は、https://www.githubstatus.com/api/v2/summary.json が全体と各欄の状態を、/api/v2/incidents.json が直近の掲示を返します。この記事の数字も、ここから取得したものです。
データ所在地を選んだ企業向けGitHubは、別のページを見る
GitHub Enterprise Cloud で「データ所在地(data residency)」を選び、GHE.com の専用の住所で使っている会社は、地域ごとの稼働状況ページを見ます。2026年11月7日時点で、eu.githubstatus.com(EU)、au.githubstatus.com(オーストラリア)、us.githubstatus.com(米国)、jp.githubstatus.com(日本)が開けることを確認しました。日本のページの名前は「GitHub Enterprise Cloud - Japan」です。
普段 github.com を使っている大多数の人は、本体の githubstatus.com だけを見れば足ります。
② 公式が正常なのに動かないとき:自分側を順に見る
稼働状況ページに何も出ていないのに、pushやcloneが失敗する。この場合は、自分の手元から順に確かめます。8月21日の例のように掲示が遅れることもあるので、「公式が正常=自分側の問題」と決めつけない姿勢も持っておきます。
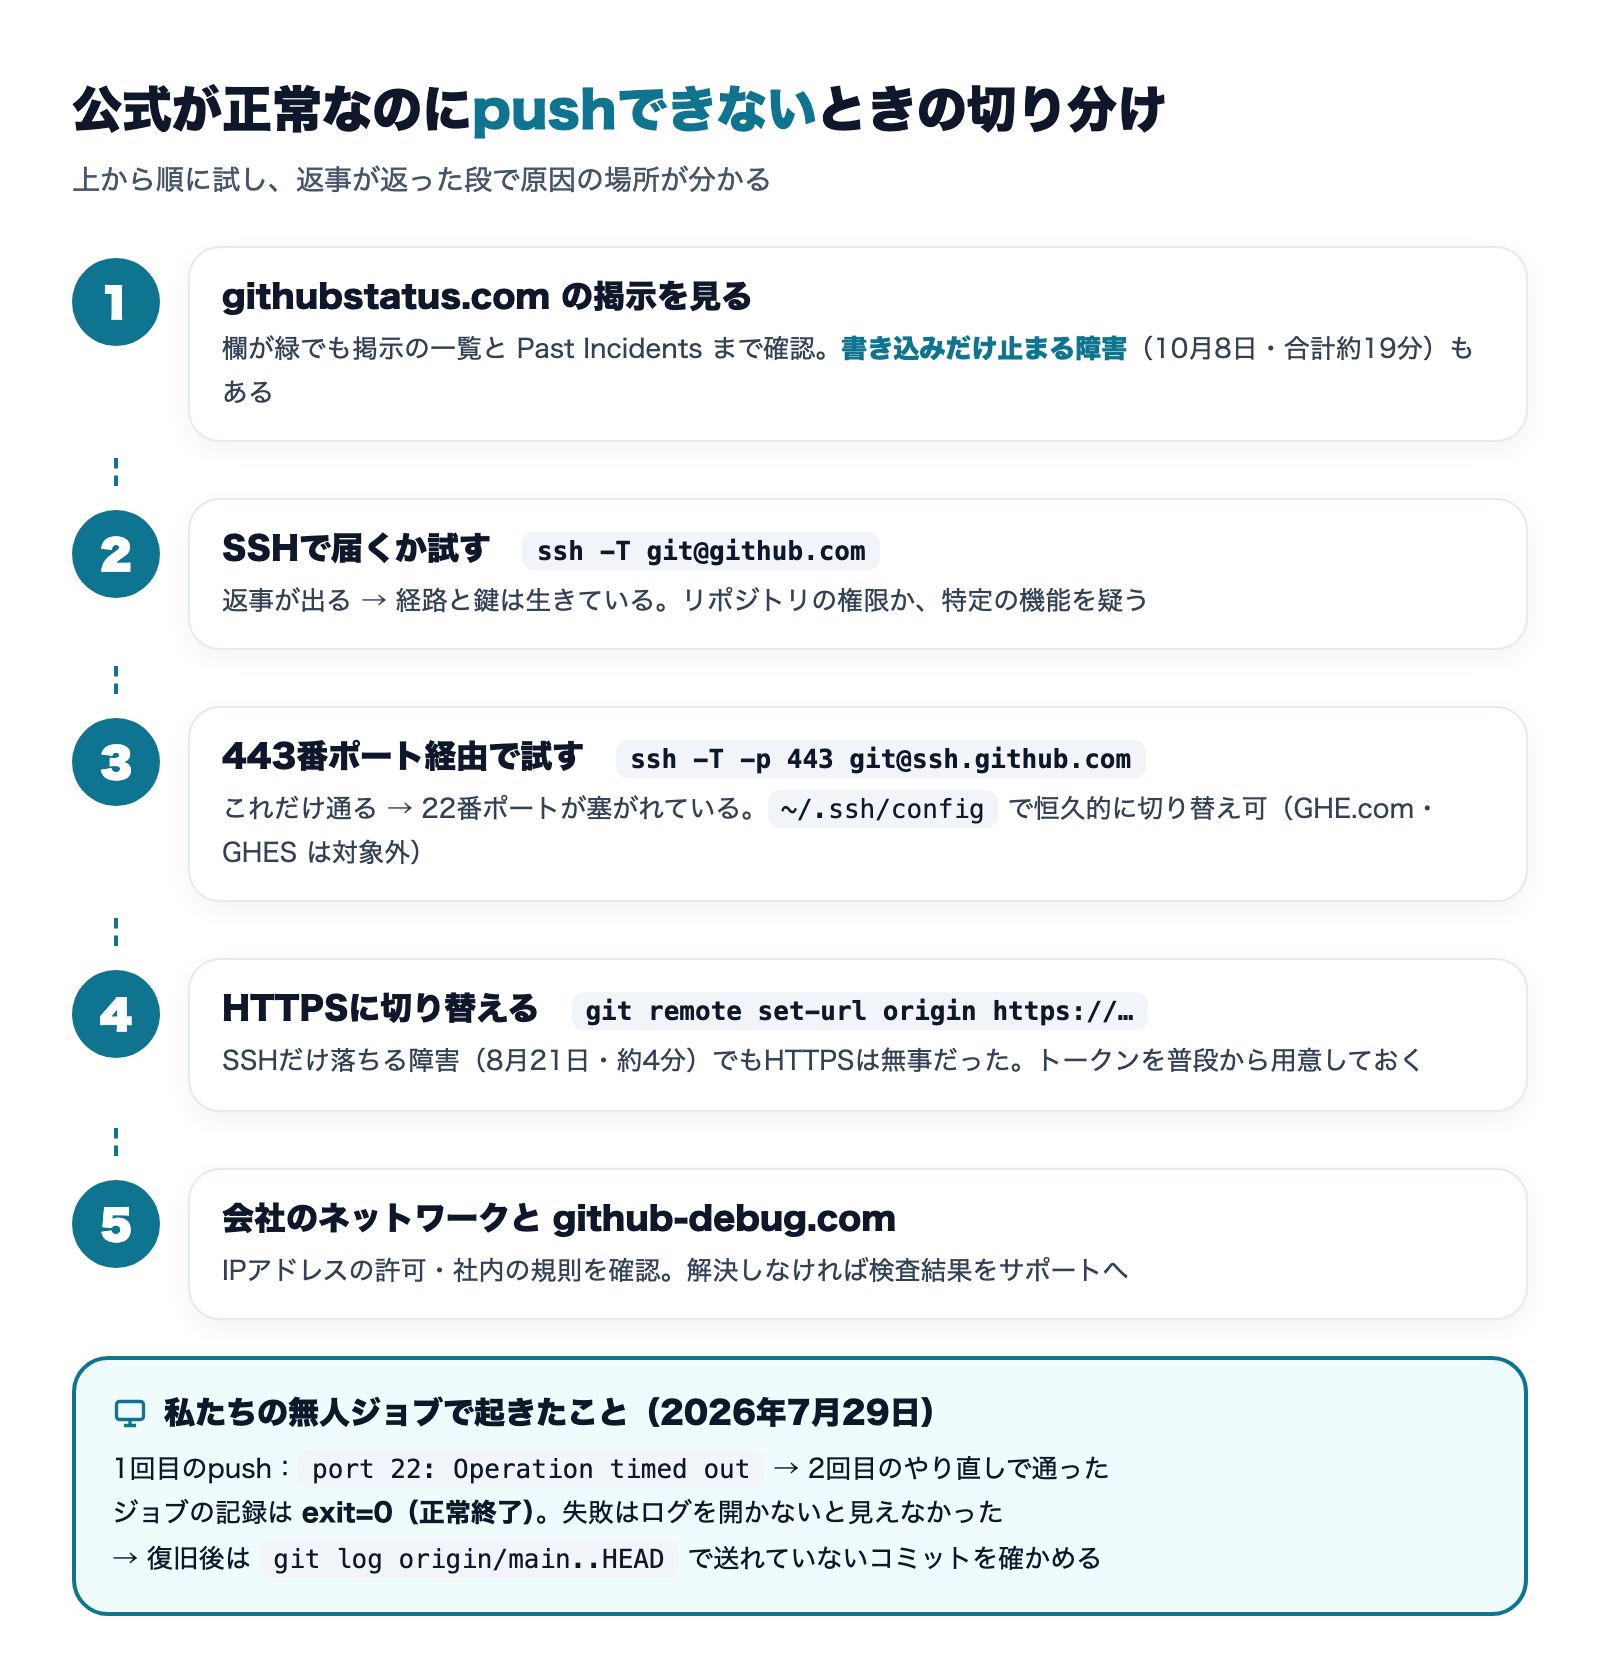
1. SSHの接続を試す:ssh -T git@github.com
まず、SSHでGitHubに届くかを確かめます。
ssh -T git@github.com成功すると、自分の名前とともに「認証には成功したがシェルは提供しない」という趣旨の返事が返ります。この返事が出ればSSHの経路と鍵は生きているので、問題は個別のリポジトリの権限か、GitHub側の特定の機能にあります。
返事が無いまま時間切れ(Operation timed out)になる場合は、22番ポートへの通信がどこかで止まっています。次の手に進みます。
2. 443番ポート経由のSSHを試す
社内やホテルのネットワークでは、SSHが使う22番ポートだけが塞がれていることがあります。GitHubは、HTTPSと同じ443番ポートでSSHを受ける入口を用意しています。公式ドキュメントの手順は次のとおりです。
ssh -T -p 443 git@ssh.github.comこれで返事が返るなら、22番ポートが塞がれていたということです。毎回この経路を使うには、~/.ssh/config に次を足します。
Host github.com
    Hostname ssh.github.com
    Port 443
    User git
注意点が2つあります。接続先の名前は github.com ではなく ssh.github.com であること。そして公式ドキュメントによると、この方法は GitHub Enterprise Server と、データ所在地を選んだ GitHub Enterprise Cloud では使えません。
3. HTTPSに切り替える
SSHの経路がどうしても通らないときは、HTTPSに切り替えます。8月21日の障害は、まさに「SSHだけが落ちてHTTPSは無事」でした。今の接続先は次で確かめられます。
git remote -vgit@github.com: で始まっていればSSH、https://github.com/ で始まっていればHTTPSです。一時的に切り替えるなら次のようにします(OWNER/REPO は自分のものに読み替えてください)。
git remote set-url origin https://github.com/OWNER/REPO.gitHTTPSではパスワードの代わりにトークンなどの認証が必要になります。復旧したら、元のSSHの住所に戻すのを忘れないようにします。
4. 会社のネットワークと、GitHubのデバッグページ
上の3つでも通らない場合、公式ドキュメントは次を挙げています。
- ネットワークがGitHubのIPアドレスを許可しているか確かめる
- 会社のネットワークなら、管理者にGitHubへの通信が規則で止められていないか確認してもらう
- 特定の時間帯だけ遅いなら、回線の混雑の可能性が高い(GitHubは利用者ごとに帯域を絞っていない)
- それでも解決しなければ
github-debug.comの検査を実行し、結果をGitHubのサポートに送る
私たちの運用で起きたこと:pushの失敗が「成功」の記録に埋もれていた
ここからは、私たちが無人で回している定期ジョブの実例です。障害そのものより、障害に気づけない作りのほうが怖い、という話になります。
無人のジョブは、毎回GitHubから始まり、GitHubで終わる
私たちは、AIに任せた定期の仕事(記事の下書き、ニュースのまとめ、発信の準備など)を、社内のMac miniで1日に十数本回しています。どのジョブも、始めにGitHubから最新の手順書と台帳を取ってきて手元を揃え、終わりに成果物をコミットしてGitHubへpushします。GitHubは、複数のマシンと人のあいだで仕事を受け渡す「共有の机」になっています。
この作りだと、GitHubが止まった影響は2か所に出ます。始めの取得が失敗する場合と、終わりのpushが失敗する場合です。
2026年7月29日:1回目のpushが時間切れ、2回目で通った
2026年7月29日12時30分に始まったジョブのログに、次の行が残っていました。
ssh: connect to host github.com port 22: Operation timed out
fatal: Could not read from remote repository.
ジョブは、pushに失敗したら一度だけ「最新を取り込んでからやり直す」作りにしてあります。このときは2回目で通り、成果物はGitHubに届いていました。ジョブ全体の記録は exit=0(正常終了) で、チャットへの完了報告も通常どおりでした。
つまり、1回目の失敗は、ログを開かない限り誰も気づけなかったのです。この時間帯にGitHub側で障害が掲示されていたのか、こちらの回線の問題だったのかは、今となっては確かめられません。この記事を書くために取得した掲示の一覧は8月5日以降の分で、7月29日には届かなかったからです。記録はその場で取っておかないと、後から原因を切り分けられません。
手順を読み直して見つけた2つの穴
この1行をきっかけに、ジョブの始めと終わりの手順(シェルスクリプト)を読み直したところ、穴は2つありました。
- 始めの取得の失敗が、黙って捨てられていた:最新の取得に失敗しても、エラーを捨てて、手元に残っている前回の状態に揃えて先へ進む作りでした。GitHubが止まっている間は、古い手順書のまま仕事をすることになります。止まるより気づきにくい失敗です
- pushが2回とも失敗しても、ジョブは「成功」で終わり、成果物が次の回に消えうる:pushに失敗すると「最新を取り込んでから1回だけやり直す」作りですが、それも失敗した場合、終了の記録にも完了報告にも失敗は反映されません。pushできなかったコミットは手元にだけ残り、次のジョブが始めに手元をGitHub上の状態へ揃え直すと、作業中の状態から外れます(Gitの操作履歴には残るので取り戻せますが、気づかなければそのままです)
10月8日の障害を思い出してください。止まったのは書き込みだけで、読み込みはおおむね通っていました。私たちの作りに当てはめると、始めの取得は成功し、終わりのpushだけが失敗する。2つ目の穴に、ちょうど落ちる形です。この時間帯(日本時間の0時〜2時ごろ)は、実行記録を見ると動いたジョブが無かったので、実害は出ていません。
GitHubが落ちている間、業務を止めないための備え
実例と公式の報告から、私たちが入れている備え、入れるべきだと考えている備えをまとめます。
pushの失敗を「成功」の記録に混ぜない
無人の処理で一番大事なのは、GitHubとのやり取りの失敗を、終了の記録に反映させることです。中身の仕事が成功していても、pushが最後まで通らなかったなら、それは「届いていない」という失敗です。完了報告に「push失敗」と一言出すだけで、7月29日のような見逃しは防げます。
手元で確かめるときは、次の2つのコマンドが役に立ちます。
git status
git log origin/main..HEAD --oneline1つ目で「originより先に進んでいる」と出たり、2つ目で何か表示されたりしたら、まだGitHubに送れていないコミットがあります(main は使っているブランチ名に読み替えてください)。
再試行は「回数を決めて、間を空ける」
8月17日の障害で見たとおり、すぐに何度も繰り返す再試行は、相手の回復を遅らせる側に回ります。私たちのジョブも「やり直しは1回だけ」にしています。無人の処理で再試行を入れるなら、回数の上限と、回を追うごとに長くなる待ち時間をセットにします。
そのうえで、上限に達したら人に知らせて止める。数分で直る障害なら次の定期実行で自然に追いつくので、無理に粘る必要はありません。
締切のある処理をActionsだけに寄せない
直近50件で最も多く掲示に紐づいていた欄はActions(12回)でした。リリース作業や顧客向けの定時処理など、締切のある仕事をActionsだけで回していると、障害の日にそのまま遅れます。手元のマシンで同じ処理を手で実行できる手順を、1枚残しておくだけでも違います。
SSHとHTTPSの両方の経路を、普段から使える状態にしておく
8月21日のように、片方の経路だけが落ちる障害があります。SSHを普段使いにしているなら、HTTPSで認証できるトークンも用意しておく。逆も同じです。障害の最中に初めてトークンを作るのは、焦りの中でやる作業としては重すぎます。
GitHubの障害が復旧したあとにやること
- 送れていないコミットを確かめる:上の
git log origin/main..HEADで何か出たらpushし直す。無人のジョブは、障害の時間帯に動いた回の記録を開いて確認する - 止まっていた自動処理をやり直す:障害中に失敗したActionsの実行や、届かなかった通知・自動デプロイは、復旧後に自然には再開しないことがある。必要なものを手で再実行する
- 切り替えた設定を戻す:HTTPSや443番ポートへ一時的に切り替えた場合は、元に戻すか、そのまま使うかを決めておく
- 事後報告を読む:解決後、同じ掲示に原因と再発防止策が追記されることがある。自分の作りに当てはめると、次の穴が見つかることがある
よくある質問
githubstatus.com は正常なのに、pushだけ失敗します。どちらを信じればいいですか
まず ssh -T git@github.com で接続を確かめてください。返事が返らなければ自分側の経路の問題の可能性が高く、443番ポート経由やHTTPSで回避できます。ただし、8月21日のSSHの障害は3日後に掲示されたので、「掲示が無い=GitHubは無事」とは言い切れません。数分待ってから再度試すのも有効です。
画面は見られるのに、pushやマージだけができません
10月8日の障害がまさにその形でした。書き込みだけが止まり、読み込みはおおむね通っていました。稼働状況ページの「Git Operations」「Pull Requests」の色と、掲示の本文に「write(書き込み)」という言葉が出ていないかを確認してください。
GitHub Copilotだけが動きません。GitHubの障害ですか
稼働状況ページの「Copilot」と「Copilot AI Model Providers」の欄を見てください。直近50件では、特定のAIモデルだけがエラーになる掲示が8回ありました。その場合は、別のモデルに切り替えると続けられることがあります。会社で使っている Microsoft 365 Copilot は別のサービスで、確認先も違います。
過去にGitHubで障害があったかを、後から調べられますか
githubstatus.com の「Incident History」で月ごとの掲示を遡れます。プログラムから読むなら、/api/v2/incidents.json が直近の掲示を返します(2026年10月20日時点で取得できたのは直近50件)。GitHubは月ごとに可用性の報告を公式ブログで出しており、たとえば2026年7月分は8月12日に公開され、7月の8件の障害の経緯が書かれています。
障害の時間帯のpushは、データが失われていませんか
10月8日の障害について、GitHubは「データベースのデータ消失は無く、復旧後に再試行した操作は成功した」と報告しています。気をつけるべきはGitHub側より手元側で、送れなかったコミットが手元に残ったままになっていないかを、復旧後に確かめてください。
まとめ
- GitHubの障害は githubstatus.com で確認する。上の欄の色だけでなく、掲示の一覧と過去の掲示まで見る(直近50件のうち22件は、どの欄にも紐づいていなかった)
- 影響度(critical など)と欄の色は別物。自分が使っている欄と、掲示本文の「何が遅れるか」で判断する
- 公式が正常なら、
ssh -T git@github.com→ 443番ポート経由(ssh.github.com)→ HTTPS の順で自分側を切り分ける - 掲示は後付けになることがある。8月21日のSSHの障害は3日後に掲示された
- 無人の処理は、pushの失敗を終了の記録に反映させる。私たちのジョブでは、7月29日に1回目のpushの時間切れが「正常終了」の陰に隠れていた。手順を読み直すと、2回とも失敗しても「正常終了」になる作りだった
GitHubは、コードだけでなく仕事そのものの受け渡しに使われるようになり、止まったときの影響が広がっています。株式会社Fyveでは、こうした無人の仕組みを自社で回しており、止まったときに気づける作りが大事だと考えています。
Copilotの稼働状況の確認方法は、こちらの記事でまとめています。
AIのコーディングツールで同じ型の切り分けを知りたい方は、Codexの記事も参考になります。
Claude CodeからGitHubを操作する設定は、こちらで解説しています。
Claude Code GitHub連携の設定方法|Git操作・worktree・CI/CDを実例で解説【2026年版】
参考にした情報源
- GitHub Status(githubstatus.com)(各欄と掲示・2026年10月20日に確認、11月7日に再確認)
- GitHub Status API:直近の掲示の一覧(2026年10月20日に取得・8月5日〜10月20日の50件)
- GitHub Status:2026年10月7日(UTC)の書き込み障害の事後報告
- GitHub Status:2026年8月17日の障害の事後報告
- GitHub Status:2026年8月21日のSSH障害の事後報告
- GitHub Status:2026年10月19日(UTC)のActions・Pages・Webhookの障害
- GitHub Docs:Using SSH over the HTTPS port
- GitHub Docs:Troubleshooting connectivity problems
- GitHub Blog:GitHub availability report: July 2026(2026年8月12日公開)
- GitHub Enterprise Cloud - Japan の稼働状況ページ(2026年10月20日に確認)
御社の業務に合わせたCopilot導入・定着支援
「ライセンスを配ったのに使われない」を終わらせる。
業務の棚卸しから、効く業務の切り分け、社内への定着まで一貫して支援します。