imozuruの使い方|Claude Codeの文献調査スキル

「imozuruというClaude Codeのスキルが話題だけど、何が普通の調べものと違うのか」「入れ方は分かったが、自分の調べものに向くのか判断できない」——知らない分野をAIに調べさせて、もっともらしい要約だけが返ってきたとき、多くの人がこのもやもやを抱えます。
結論から言うと、imozuruは要約を返さず、原文を保存して「主張ごとにどのファイルの何行目か」を示すところで止まる調査スキルです。分野の用語・中心の人・知見が集まる場を先に押さえ、そこから引用やリンクをたどって原文に行き着きます。入れ方は npx skills add MaryCache/imozuru の1行で、スクリプトはPython 3.10以上の標準ライブラリだけで動きます。
株式会社Fyveは、中小企業のAI導入を支援しながら、自社の業務も多数のClaude Codeスキルで回しています。この記事では、公開されているREADMEとSKILL.mdを読み込んだうえで、同梱の見本で照合スクリプトを手元で動かした結果と、私たちの調べものの決まりとの重なりを交えて、imozuruの使い方と向く調べものを整理します。
imozuruとは:原文にたどりつくまで芋づる式に掘るClaude Codeスキル
imozuruは、GitHubで公開されているClaude Code用のスキルです。リポジトリの説明文は「知らない分野を、原文にたどりつくまで芋づる式に掘る Claude Code のスキル」。READMEによると、図書館情報学の情報探索の研究(berrypickingと呼ばれる探索のモデルなど)から考え方を応用しています。
2026年10月20日にGitHubのAPIで確認した基本情報は次のとおりです。
項目 | 内容(2026年10月20日時点) |
|---|---|
リポジトリ | MaryCache/imozuru |
公開日 | 2026年10月13日(リポジトリの作成日) |
最終更新 | 2026年10月19日(コミット15件) |
スター数 | 754 |
ライセンス | MIT |
動作に必要なもの | Claude Code、Python 3.10以上(標準ライブラリのみ) |
READMEの言語 | 日本語(英語版あり) |
公開から1週間で、コミットの多くが「SKILL.mdの言葉の手直し」と「Windows・文字コードまわりの修正」です。作者が試しながら決まりを直している最中のスキルなので、入れる時点で最新のREADMEを読み直すことをおすすめします。
ふつうに「調べて」と頼んだときとの違い
READMEは、スキルなしでAIに「調べて」と頼んだときの弱点を2つ挙げています。
- 検索上位の数件を読んで要約を返す。すぐ読めるが、判断に必要な細部が落ちやすい
- 分野の用語を知らないうちは検索語を選べない。最初に思いついた言葉の範囲から先へ進めない
imozuruはこの2つに、順番を変えることで対処します。いきなり答えを探すのではなく、まず「この分野では何と呼ぶのか」「誰が中心にいるのか」「知見はどこに集まっているのか」を地図にします。そのうえで、参考文献・被引用・著者・記事内のリンクをたどって原文を集めます。
もう1つの大きな違いは、集めた原文を要約しないことです。SKILL.mdには理由として、調べ始めの混乱した段階で詳しくまとめると「早すぎる結論(premature closure)」を招き、調べる過程を妨げるという1991年の情報探索の研究が挙げられています。判断するのは原文を読むユーザーで、AIは原文の場所を指すだけ、という役割分担です。
素のClaude Codeに「調べて」 | imozuruを使う | |
|---|---|---|
最初にやること | 思いついた言葉で検索 | 用語・人・場の地図を作る |
返ってくるもの | 要約・解説 | 保存した原文と、主張ごとの「ファイル名+行番号+短い引用」 |
止めどき | AIが「答えが出た」と感じたとき | 主張の全部に原文が付いたか、新しい資料が出なくなったとき |
論文のない分野 | まとめ記事の要約になりやすい | 個人のブログ・動画の字幕もたどり、出どころの印を付ける |
結果の置き場 | 会話の中だけ |
|
imozuruの動き方:問い→地図→たどる→抜き書き
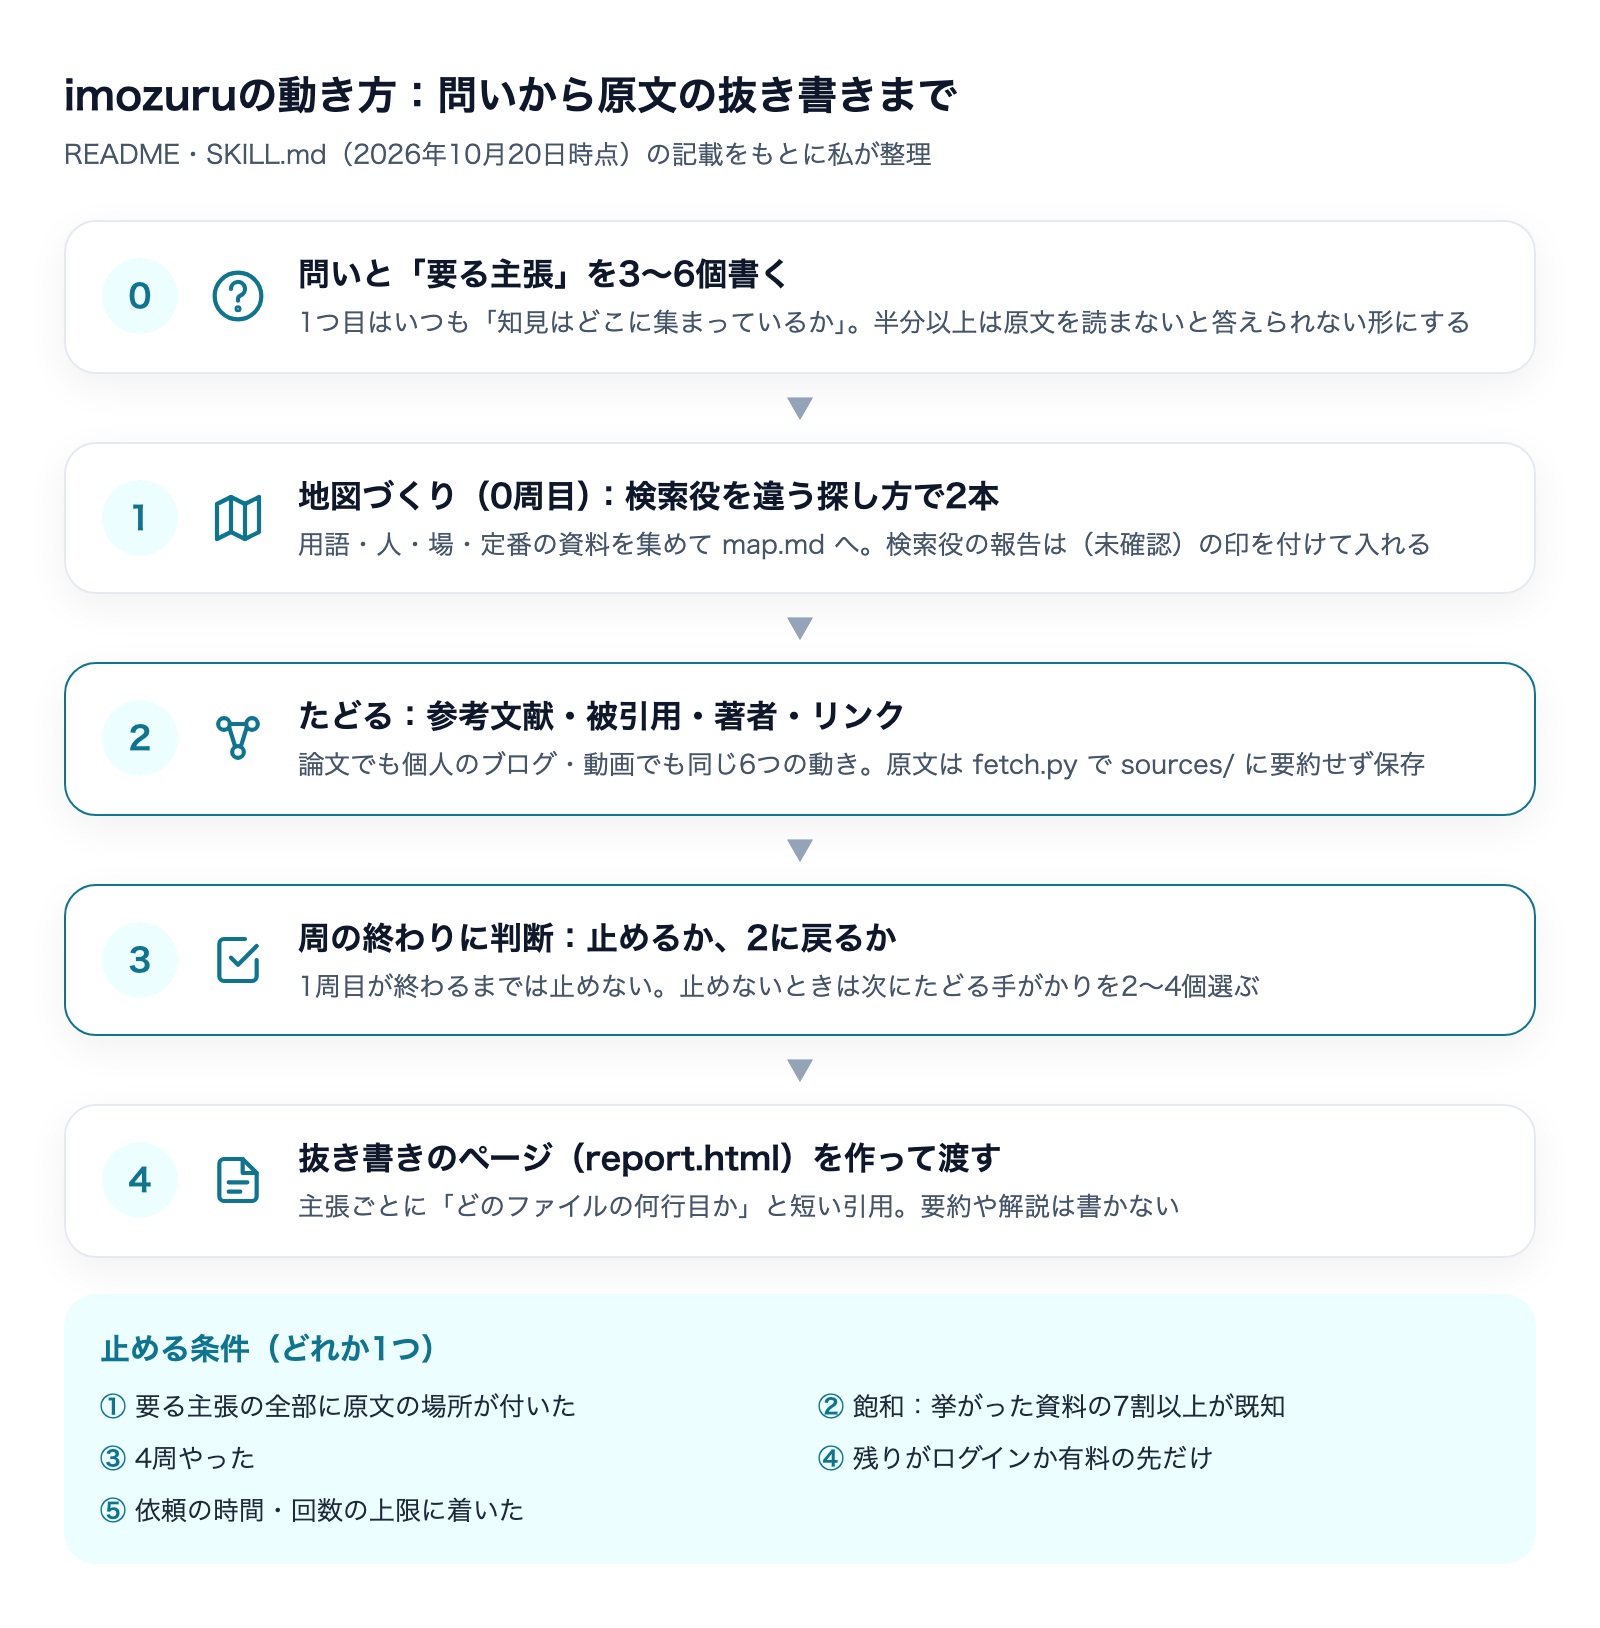
SKILL.mdに書かれた流れを、私が1枚に整理したのが次の図です。
0. 問いと「要る主張」を3〜6個書く
最初に、問いと、答えるのに必要な主張を3〜6個書き出します。この主張が「いつ調べるのをやめるか」の基準になります。SKILL.mdには、主張の作り方に細かい決まりがあります。
- 1つ目は、いつも「この分野の知見はどこに集まっているか(場)」にする
- 少なくとも1つは、依頼の言葉の条件をそのまま入れる
- 「〜がある」だけで埋めず、半分以上は「どれくらい効果があるか」「どこで失敗するか」のように原文を読まないと答えられない形にする
- コツを聞く問いでも、1つは「そのコツの元になった原典・研究はあるか」にする
この決まりは、作者の試しの失敗から足されています。主張が5つとも「〜がある」の形だったため1周で原文が付いて止まり、依頼の中心の条件が確かめられないまま残った、という記録がSKILL.mdに残っています。
1. 地図づくり(0周目):検索役を違う探し方で2本
次に、Webを検索するサブエージェント(SKILL.mdでは「検索役」)を、違う探し方で2本並べます。既定は英語と日本語です。検索役に頼むのは、用語・人・場・定番の資料の4つを、出典のURLつきで拾うこと。要約は頼まず、ファイルも書かせません。
検索役は軽いモデル(Haikuなど)で足りる、とSKILL.mdは書いています。広く浅く探す仕事は途中で判断が要らないからです。一方で、検索役の報告はたいてい検索結果の抜粋がもとで、原文を開いていません。そのため地図(map.md)に入れるときは末尾に「(未確認)」と付け、原文で確かめたら外します。
2. たどる:論文でも個人の発信でも6つの動き
地図ができたら、何度も名前が出る資料や定番として引かれる資料から、原文をたどります。たどり方は6つで、論文の世界と個人の発信の世界で同じ動きをします。
動き | 論文なら | 個人の発信なら |
|---|---|---|
後ろへ | 参考文献 | 記事の中のリンク、「〇〇さんの記事を参考に」 |
前へ | 被引用(多い順) | その記事を紹介・引用している記事や投稿 |
著者で追う | 著者の他の論文 | その人のブログの過去記事、Zenn・Qiita・noteの投稿一覧、YouTubeのチャンネル |
場を通しで見る | 中心の学会・雑誌 | Qiita・Zennのタグ、Reddit、awesomeリスト |
近くを眺める | 同じ号・同じ一覧 | 関連記事、同じタグ、同じ人の再生リスト |
言葉で引き直す | 地図に増えた用語で検索 | 界隈の俗称・略語でも引く |
論文の引用は chain.py が無料のOpenAlex APIでたどります(APIキー不要・1日1,000回までの無料枠)。原文の保存は fetch.py が担当し、404・ログイン要求・短すぎる本文は FAIL として除きます。PDFはテキストに、HTMLはMarkdownに、YouTubeは字幕を時刻つきで保存します。
見落としやすい注意として、SKILL.mdは「出て1年ほどの論文は chain.py が0件を返す。0件は『無い』ではない」と書いています。引用データの登録が追いついていないためで、その場合は保存した本文の参考文献の節を検索して代わりにたどります。
3. 周の終わりの判断:止める条件は5つ
調べものは「周」で区切って進み、周の終わりに止めるかどうかを決めます。止める条件は次の5つのどれかです。
- 要る主張の全部に、原文の場所(ファイル名と行番号、短い引用)が付いた
- 飽和した:その周に検索役が挙げた資料の7割以上が、すでに地図にあった
- 4周やった
- 残りの原文が、どれもログインか有料の先にある
- 依頼に時間・回数の上限があり、そこに着いた
7割という目安は「試しながら決めた仮の目安」とREADMEにも明記されています。また、AIの検索は早くやめて外す(under-search)のも典型的な失敗なので、1周目が終わるまでは止めません。0周目で全部に原文が付いたように見えても、1回はたどってから判断します。
4. 渡す:抜き書きのページと「感覚と合った?」
止めたら、止めた理由、主張ごとの原文の場所、届かなかったもの、抜き書きのページ(report.html)のパスを返します。ログインや有料で読めないが大事そうなものは、URLと理由だけを並べ、ユーザーが自分のブラウザで開く形です。AIがアカウントを作ったりログインしたりはしません。
最後に、ユーザーに「感覚と合った?」と一言だけ聞き、答えをそのまま log.md に残す決まりがあります。止めどきの7割や周の上限を変えるかは、この記録を何回分か並べて決める、とSKILL.mdは書いています。スキル自体を使いながら育てる設計です。
原文に付ける5つの印:どれを信じるかはユーザーが決める
imozuruは、塗り方や音のミックスのように論文がほとんどない分野では、個人のブログや動画も論文と同じようにたどります。その代わり、保存した原文には出どころの印を付けます。
印 | 意味 |
|---|---|
〔論文〕 | 査読や学会を通ったもの、arXivのプレプリント |
〔本人〕 | やった本人の記録(自分で試した・作った・測った過程があるもの) |
〔観察〕 | 他人の作品ややり方を見て、特徴を書き出したもの |
〔まとめ〕 | 他人の知見を集めたり言い換えたりした記事 |
〔公式〕 | 道具や製品を作った側の文書 |
この区別は、AIの調べものを業務で使うときにそのまま役立ちます。〔まとめ〕だけで組み立てた結論と、〔本人〕や〔公式〕に当たって確かめた結論とでは、同じ文面でも重みがまったく違うからです。
imozuruの入れ方
skillsのCLIで入れる
READMEに書かれている入れ方は、Vercelが公開しているskillsのCLIを使う方法です。
npx skills add MaryCache/imozuruskillsのCLI側のREADMEによると、Node.js 22.20以上が必要で、既定では今いるプロジェクトに入ります。どのプロジェクトからでも使いたい場合は -g を付けます。調べものはプロジェクトをまたいで使うことが多いので、私なら -g を付けます。skillsのCLIそのものの仕組みは、別の記事で詳しく書いています。
手動で入れる
手動の場合は、リポジトリの skills/imozuru/ フォルダを ~/.claude/skills/imozuru/ にコピーします。フォルダの中身は、本体の SKILL.md、理論の出典をまとめた references/theory.md、4本のスクリプト(fetch.py・chain.py・report.py・watch.py)です。
あると使える外部コマンド
スクリプトは標準ライブラリだけで動きますが、次のコマンドが入っていれば使います。無くても止まらず、該当する資料だけが FAIL になります。
コマンド | 使う場面 | 無い場合 |
|---|---|---|
pdftotext(poppler など) | PDFから本文を取り出す | PDFの本文が取れず FAIL |
pdftoppm と tesseract | 文字の層がない古いPDFをOCRにかける | そのPDFは FAIL |
yt-dlp | YouTubeの字幕を取得する | 動画は FAIL |
ax | HTMLをMarkdownにする | 標準ライブラリで文字だけ取り出す |
Macなら、PDFを多く扱う調べものの前に poppler を入れておくと取りこぼしが減ります。
imozuruの使い方:頼み方と結果の置き場
入れたあとは、Claude Codeに次のように頼むだけです(READMEの例)。
芋づる式に調べて: 歌ってみたのMIXで、上手い人がどういう順番で処理しているかGaussian Splattingってよく聞くけど全然わからない。論文とか解説の流れを掘ってほしいSKILL.mdの説明文には「芋づる式に調べて」「この分野をキャッチアップしたい」「論文とか先行研究を漁って」「元ネタを探して」など、反応する言い方が並んでいます。逆に、答えが1つの事実の確認(年・有無・仕様1つ)や、手元のPCの資料探し、読んだ資料の要約には使わないと明記されています。
結果は ~/research/<話題>/ に次の形で残ります。
ファイル | 中身 |
|---|---|
map.md | 問い・要る主張・用語・人・場・原文の表・次の手がかり |
log.md | 周ごとに、何を探して何が出たか、判断とその理由 |
sources/ | 保存した原文(要約ファイルは置かない) |
extracts.json | 抜き書き |
report.html | 抜き書きのページ |
見張りのモード(watch)
もう1つの使い方が見張りのモードです。/imozuru watch react のように頼むと、調べたときの地図にある場(Qiita・Zennのタグ、note、YouTube、ブログ、arXivなど)の新着をRSSで集めて並べます。検索を使わないので費用はかからず、結果も揺れません。XはRSSを出していないので見張れない、とSKILL.mdに書かれています。
なお、見張りは「ユーザーが頼んだときだけ回す」決まりで、定期の自動実行にするかは「何回か思いどおりに動いてから決める」とされています。
抜き書きの照合を手元で試した結果
imozuruの中で、私がいちばん実務的だと感じたのは report.py の照合です。READMEには「切り出した文が原文の指定の行にそのまま在るかを照合し、1語でも違えばページを作らない」とあります。リポジトリには見本(examples/demo/)が同梱されていて、スクリプトだけを試せるので、2026年10月20日に手元のMacで動かしました。
正直に書いておくと、私が試したのはこの照合のスクリプトだけです。検索役を使って実際に分野を掘る本体の流れは、まだ自分の題材で回していません。
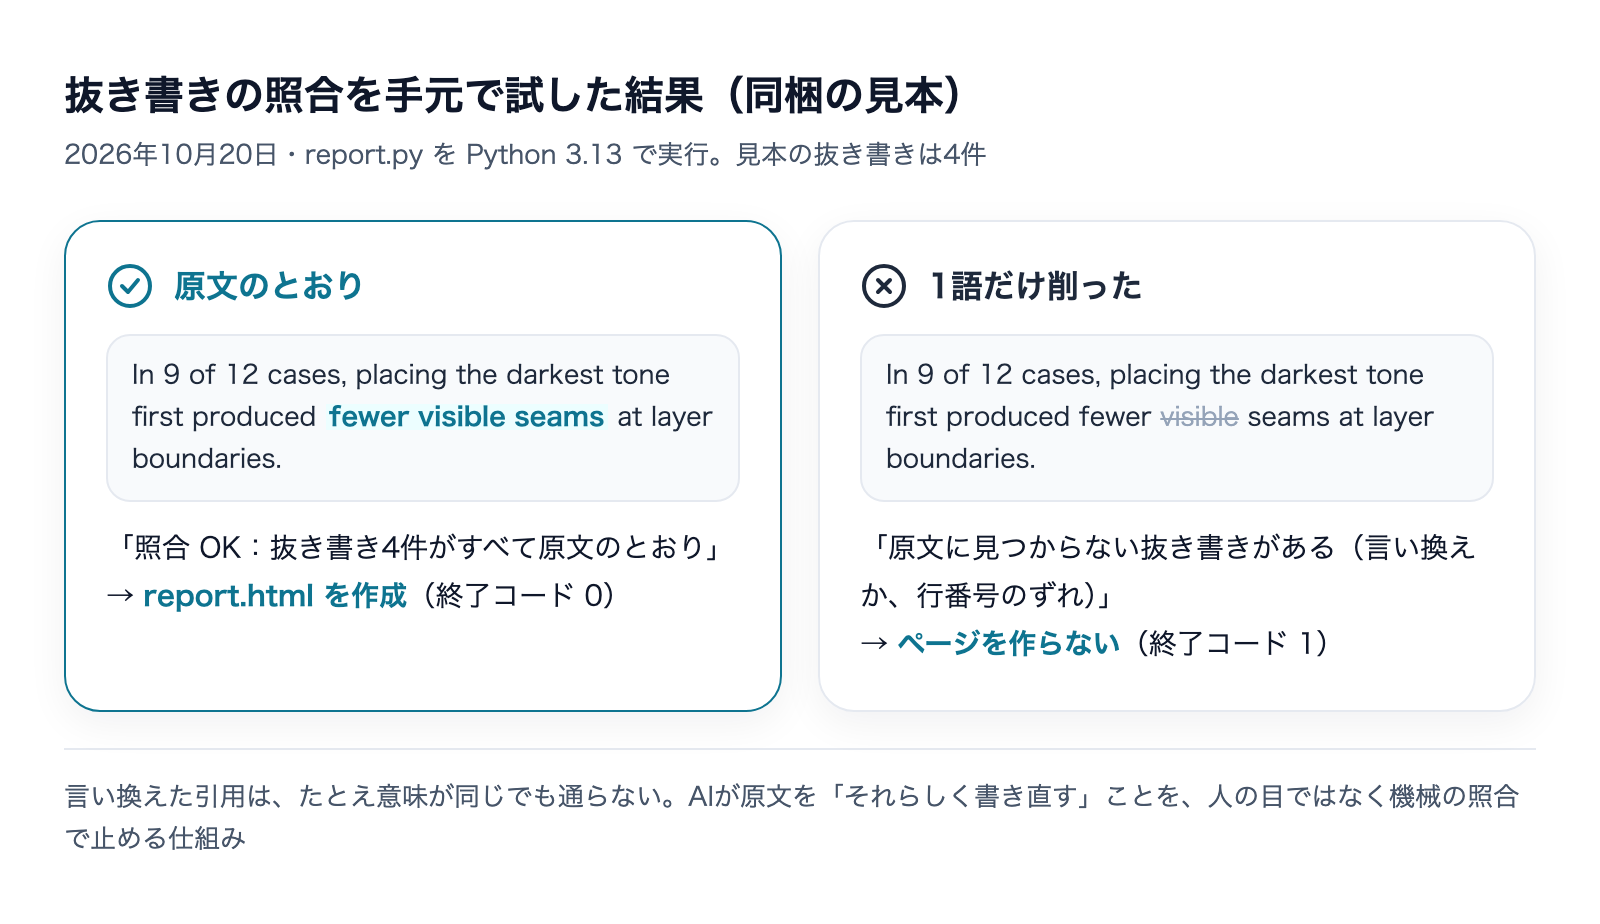
やったことは2つです。
- 見本のまま実行:「照合 OK: 抜き書き 4 件がすべて原文のとおり」と出て、
report.htmlが作られました(終了コード0) - 抜き書きの英文から1語だけ削って実行:「fewer visible seams」を「fewer seams」に変えると、「原文に見つからない抜き書きがある(言い換えか、行番号のずれ)」と出て、ページは作られませんでした(終了コード1)。照合だけを行う
--checkでも同じ結果です
意味がほぼ同じ言い換えでも通さない、という点が肝心です。AIに原文を引用させると、それらしく整えた文を「引用」として出してくることがあります。人が毎回原文と突き合わせるのは大変なので、ここを機械の照合に任せられるのは大きいと感じました。
動かす前に、report.py の中身を読んで、使っているのが標準ライブラリ(html・json・re・sys・pathlib)だけで、ネットワークに出る処理が無いことを確かめています。他人のスキルを入れるときは、スクリプトを一度読んでから動かすのがおすすめです。
私たちの調べものの決まりと重なるところ
imozuruの決まりを読んで、私たちが社内の調べもので失敗しながら作ってきた決まりと、ほぼ同じことが書かれている箇所がいくつもありました。
検索で拾った話は「未確認」として扱う
私たちは毎日AIの最新情報を調べています。Xの投稿だけで出てきた新情報は、公式の発表やGitHubのリリースノート、npmの公開情報で確かめ直すまで使わない決まりにしています。AIの検索は、存在しない機能や数字をもっともらしく返すことがあるからです。
imozuruの「検索役の報告は原文を開いていないことが多いので(未確認)と付け、原文で確かめたら外す」という決まりは、これと同じ考え方です。実際、この記事のきっかけになったimozuruの紹介もXの投稿で、リンク先を特定してGitHubのREADMEとAPIで確かめてから書いています。
0件は「無い」ではない
AIに調べさせて「該当なし」と返ってきたとき、それをそのまま信じて失敗したことが何度もあります。imozuruの「新しい論文は引用データが0件になる。0件は『無い』ではない」という注意書きは、まさにこの問題です。0件が出たときに疑うべきは、対象ではなく探し方のほうです。
判断は重いモデル、広く浅い作業は軽いモデル
私たちはClaude Codeで、判断が要る作業と、手数が多く判断の少ない作業を、別のモデルに分けて任せています。imozuruも同じで、探索の判断をする「親」と、軽いモデルで足りる「検索役」を分けています。検索役の同時起動を2本までに制限しているのも、費用と結果の読みやすさを考えた設計です。
imozuruが向く調べもの・向かない調べもの
README・SKILL.mdの記載と、私たちの業務での調べものの種類を照らし合わせると、向き不向きは次のように整理できます。
向く | 向かない |
|---|---|
自分の知らない業界・制度・技術にキャッチアップする | 答えが1つの事実の確認(発売日・料金・仕様1つ) |
要約ではなく原文で判断したい(提案の根拠を示したい) | 社内資料・手元のファイルを探す |
「上手い人のやり方」の元ネタ・原典を探す | 読んだ資料の要約や解説を書かせる |
論文と個人の発信が混ざる分野を横断する | 顧客名や社内の数字が絡む調べもの(検索語が外部に出る) |
同じ分野の新着を定期的に追いたい(watch) | すぐ結論だけ欲しい調べもの |
中小企業の業務に置き換えると、たとえば新しく参入する業界の慣習を調べる、取引先の業界で使われている専門用語と定番の考え方を押さえる、といった場面です。要約を読むより時間はかかりますが、「なぜそう言えるのか」を原文で示せるのは、社内で説明するときの強い材料になります。
入れる前に確かめておきたい注意点
- 問いの内容が検索語として外部に送られる。READMEも「機密情報や個人データが関わる調べものには使わないでください」と書いています。顧客名・社内の数字・未公開の計画を問いに入れないことが前提です
- 費用は普通の質問より大きくなる。検索役のサブエージェントを2本ずつ、最大4周回すので、1回の調べものでモデルの利用量が増えます。SKILL.mdは、深い検索は費用が数倍になるため、普通の検索で欲しい種類が0件のときだけ使うよう決めています
- 保存した原文は再配布しない。手元で読むための写しです。社内共有も、原文ではなくURLと行番号で行うのが安全です
- 有料の論文を回避して入手しない。取れなかったものは「届かなかった」と報告される設計です
- 公開から日が浅い。2026年10月13日公開で、決まりの手直しが続いています。入れる前と、しばらく使ったあとに、最新のSKILL.mdを読み直してください
スキルを選ぶときの一般的な判断軸は、こちらの記事にまとめています。
よくある質問
imozuruは無料で使えますか?
スキル自体はMITライセンスで無料です。ただし動かすにはClaude Codeが必要で、検索役のサブエージェントや検索の分だけClaude Codeの利用量を使います。引用をたどるOpenAlex APIは、APIキー不要の無料枠(1日1,000回まで)で使う設計です。
Windowsでも動きますか?
2026年10月15日のコミットで「Windows(cp932)と Python 3.10 で止まらないようにする」修正が入っています。ただし私はMacでしか試していないため、Windowsでの動作は確かめていません。
Claude Codeの標準のWeb検索と何が違いますか?
Web検索そのものは同じClaude Codeの機能を使います。違うのは、検索の順番(地図を先に作る)、止めどき(主張の全部に原文が付くまで)、結果の形(要約ではなく原文と行番号)を、スキルの決まりとして固定している点です。
日本語の資料だけを調べられますか?
既定では、英語と日本語の2本の検索役で地図を作ります。SKILL.mdには「日本語で検索語が見つからない分野は英語で始める」とあり、日本語だけに絞ると取りこぼしが増える設計です。
まとめ:要約ではなく、原文の場所を受け取る調査スキル
- imozuruは、知らない分野を用語・人・場の地図から掘り、原文を保存して主張ごとに「何行目か」を示すClaude Codeスキル(2026年10月13日公開・MIT)
- 入れ方は
npx skills add MaryCache/imozuru(既定はプロジェクト単位、全体なら-g)か、~/.claude/skills/imozuru/への手動コピー - 止める条件は、主張の全部に原文が付く・飽和・4周・ログインか有料・依頼の上限の5つ
- 抜き書きは機械で原文と照合され、1語違えばページを作らない(同梱の見本で確認)
- 問いが検索語として外部に出るため、機密や個人データが絡む調べものには使わない
AIの調べものは、速く要約が出るほど、根拠をたどる手間が省かれがちです。imozuruは、その手間をAIに肩代わりさせながら、最後の判断は人が原文で行う、という線の引き方をしています。株式会社Fyveでも、顧客への提案の根拠を調べる場面で、この考え方を取り入れていきます。
Claude Codeを「素のまま」使うな
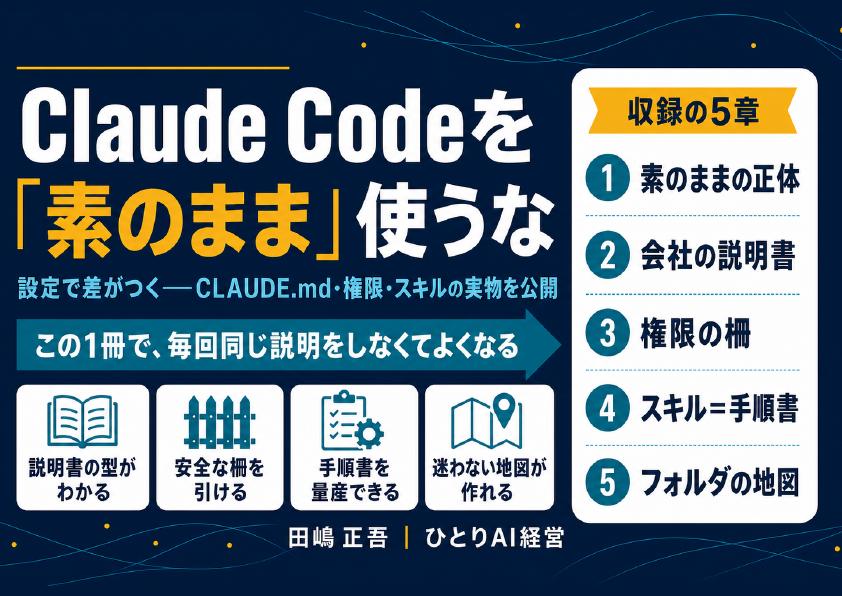
設定で差がつく——CLAUDE.md・権限・スキルの実物を公開(全24ページ)
素のClaude Codeは"優秀な新入社員"。仕事を教えるほど、自分専用になります。覚えさせる4点セット——会社の説明書(CLAUDE.md)・権限の柵・手順書(スキル)・フォルダの地図——を、1人会社の実運用からコピペで使える型つきで公開します。
- そのまま書き換えて使えるCLAUDE.mdの型
- お金と送信をAIに触らせない「3段階の柵」
- 1回教えたら何度でも動く、手順書のコピペ雛形
- AIが迷子にならないフォルダ構造の3原則
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。