GPT-5.6 Solとは|最上位モデルの実力と使いどころ

「GPT-5.6には3つのモデルがあるらしいが、最上位のSolはいつ使えばいいのか」——新しいモデルが出るたび、多くの経営者がこの迷いにぶつかります。
結論から言うと、GPT-5.6 Solは「複雑で長時間かかる、失敗が許されない作業」のここぞという場面で使う最上位モデルです。日常のメール作成や議事録要約に使うと、性能もコストも過剰になります。
株式会社Fyveは中小企業向けにAI活用の伴走支援をしており、私自身も新モデルは公開直後に一通り触って確かめています。この記事では、Solを「いつ使い、いつ使わないか」という判断軸を、非エンジニアの方にも分かる言葉で整理します。
GPT-5.6 Solとは|3ティアの最上位フラッグシップモデル
GPT-5.6は、2026年7月9日に一般提供が始まったOpenAIの最新世代モデルです。特徴は、1つのモデルではなく能力の異なる3つのモデル(ティア)で構成されている点にあります。太陽・地球・月をモチーフにした命名で、それぞれ役割がはっきり分かれています。
- Sol(ソル)=フラッグシップ(最上位)。コーディング・調査・研究・セキュリティ・設計など、複雑な作業に最も強いモデル。
- Terra(テラ)=バランス型。性能・速度・コストの釣り合いが取れた、日常業務向けの中位モデル。
- Luna(ルナ)=最速・最安。GPT-5.6ファミリーの中で最も速く、最もコストの低いモデル。
このうちSolは、OpenAIが公式ヘルプで「最も難しい仕事のための最有力モデル」と位置づけている存在です。名前で言えば太陽——ファミリーの中心にある、最も明るく力の強いモデルという立て付けになっています。
3モデルとも技術仕様の土台は共通です。一度に扱える文脈の量(コンテキストウィンドウ)は100万トークン、一度に返せる出力は最大128,000トークン、学習データの区切り(知識カットオフ)は2026年2月16日です。トークンとは、AIが文章を処理するときの最小単位(おおまかに単語や文字の断片)のことで、100万トークンは日本語で数十万字規模の資料をまとめて読み込める量にあたります。つまりSolは「大量の資料を丸ごと渡して、複雑な判断を任せる」使い方に向いた器を持っています。
GPT-5.6ファミリーの全体像や、Sol/Terra/Lunaの選び分けをまず俯瞰したい方は、Codex側の解説記事も参考になります。
GPT-5.6 Solの価格|「$5/$30」が意味すること
Solを検討するうえで避けて通れないのが価格です。API(プログラムから直接呼び出す従量課金)での標準価格は、100万トークンあたりの入力・出力で次のように設定されています。
- Sol:入力 $5.00 / 出力 $30.00(100万トークンあたり)
- Terra:入力 $2.00 / 出力 $12.00
- Luna:入力 $0.20 / 出力 $1.20(2026年7月30日に約80%値下げ)
数字を並べると分かるとおり、Solの出力単価はLunaの25倍です。同じ作業を投げても、モデルの選び方ひとつで請求額が数倍変わります。Solの価格は2026年6月下旬のプレビュー時から据え置きですが、TerraとLunaは2026年7月30日に値下げされました(Lunaは約80%、Terraは約20%の引き下げ)。下位ティアほど安くなったため、用途で選び分ける効果は以前より大きくなっています(価格・仕様の独立系のまとめはSimon Willison氏の記事でも確認できます)。
ここで中小企業の方が押さえるべきは、「ChatGPTの定額プラン」と「APIの従量課金」は別物という点です。月額のChatGPTプラン(Plus等)でSolを使う場合は、上記の$5/$30が直接請求されるわけではなく、プランの範囲内で利用できます。一方、社内システムに組み込んでAPIで呼び出す場合は、使った分だけ従量で積み上がります。
しかも、ChatGPT上で選べる具体的なモデルや設定は、契約しているプランごとに異なります。Solのような最上位モデルや後述する深い推論設定は、上位プランでないと開放されないことがあります。「Solを試したいのに選択肢に出てこない」という場合は、プラン差を疑うのが先です。
GPT-5.6 Sol/Terra/Lunaは、ChatGPT・Codex・OpenAI APIのいずれからも利用できます。用途に応じて「定額で気軽に試す」のか「システムに組み込んで従量で回す」のかを、最初に決めておくと予算がぶれません。
料金シミュレーション|実際の作業でどれくらいかかるか
数字だけだとイメージがつかみにくいので、簡単な例で計算してみます。たとえば、50ページ程度の契約書(入力にして約20万トークン相当)を読み込ませ、要点と矛盾点をまとめた報告(出力にして約5,000トークン相当)を出させる作業を想定します。
Solで実行した場合、入力コストは20万トークン×$5.00÷100万=約$1.00、出力コストは5,000トークン×$30.00÷100万=約$0.15で、合計は約$1.15(1回あたり)です。同じ作業をLunaで実行すると、入力約$0.04+出力約$0.006で合計約$0.05にとどまります。
1回あたりの差は1ドル強に見えるかもしれませんが、これを月に数十件・数百件と繰り返す業務フローに組み込むと、モデル選びの差はそのまま月間コストの差になります。だからこそ「どの作業にSolを使うか」を最初に決めておく価値があります(トークン数はあくまで目安の概算で、実際の文書量によって変動します)。
逆に、日常のちょっとした作業(例:短いメールの下書き、入力2,000トークン・出力500トークン程度)であれば、Terraでも1回あたり約$0.01、Lunaなら約$0.001とどちらも僅かな金額です。この規模の作業でモデル選びに神経質になる必要はなく、差が効いてくるのは「大量の資料を読ませる」「大量件数をさばく」場面だと覚えておけば十分です。
GPT-5.6 Sol・Terra・Lunaの使い分け|具体的な業務で判断する
「Solが一番だから、とりあえずSolを使っておけばいい」——そう考えたくなりますが、価格差を見れば得策ではないと分かります。3モデルにはそれぞれ向いている業務がはっきりあり、Sol・Terra・Lunaの違いを業務単位で理解しておくと、コストと精度のバランスが取りやすくなります。
Terraが向いている業務
Terraは性能・速度・コストのバランス型で、日常業務の主力に据えるモデルです。次のような場面で力を発揮します。
- 顧客対応メールの下書き・トーン調整
- 社内マニュアルや議事録の整理・要約
- ある程度の分量がある文書のチェック(最終判断が必要なほど複雑ではないもの)
Lunaが向いている業務
Lunaは最速・最安を担うモデルで、件数が多い・即答が求められる処理に向いています。
- チャットボットの一次応答・FAQ回答
- 短い文章の分類・タグ付けといった大量の定型処理
- 下書きの叩き台をとにかく速く出す作業
Solが向いている業務(おさらい)
前述のとおり、Solは複雑さと失敗コストの高い作業向けです。TerraやLunaで一度やらせてみて、精度が足りない・判断が浅いと感じたときに、Solへ切り替えるという使い方も現実的です。
実務での目安を整理すると、次のようになります。
- まずTerraで試す:日常業務の多くはここで足ります
- 件数が多い・速さが最優先ならLuna:チャット対応や大量の定型処理
- Terraで精度不足を感じたらSolへ:契約書チェック・設計・複雑な調査
GPT-5.6 Solはいつ使うべきか|複雑作業・長時間タスクの判断軸
ここが本題です。Solは高性能ですが、その高さがそのままコストと待ち時間に跳ね返ります。だからこそ「使いどころ」の見極めが、費用対効果を左右します。
Solが力を発揮する場面
- 大量の資料を横断して結論を出す作業:数十ページの契約書・仕様書・過去データをまとめて読ませ、矛盾点や抜けを洗い出す。
- 失敗のコストが高い作業:業務システムのコード生成、セキュリティ観点の点検、複雑な設計判断など、間違うと手戻りが大きいもの。
- 途中で方針を修正しながら進める長時間タスク:一発で答えが出ず、試行錯誤を挟む必要がある調査・研究的な作業。
Solを使わなくていい場面
- 定型メールの下書き、議事録の要約、ちょっとした言い換え。
- 短い質問への即答、社内チャットボットの一次対応。
- 大量に繰り返す単純処理(件数が多いほどコスト差が効く)。
もう少し具体的な線引きとして、次の3つの問いに「はい」が1つでもあれば、Solを検討する価値があります。逆に、すべて「いいえ」なら、TerraかLunaで十分なことがほとんどです。
- 間違えると、修正や再作業に半日以上かかるか
- 一度に読み込ませる資料が、数十ページ・数万字を超えるか
- 結論を出すまでに、複数回の試行錯誤(方針の練り直し)が必要そうか
この線引きの原則はシンプルです。「間違えたときの損失」が「高いモデルを使う追加コスト」を上回るなら、Sol。そうでないならTerraかLuna」。多くの日常業務は後者に収まります。中小企業でSolが常時必要になる場面は、実はそれほど多くありません。
Terra・Lunaでどこまで日常業務がまかなえるか、コスト階層で予算を組む考え方は、姉妹の解説と合わせて読むと立体的になります。

max reasoning・ultra modeとの相性|Solの深さを引き出す設定
GPT-5.6では、AIにどれだけ「考える時間」を与えるかを段階で指定できます。この段階(reasoning.effort=推論の深さ)に、今回「max」という最上段が新設されました。段階は下から none → low → medium → high → xhigh → max の順で、maxが最も深く考えるモードです。
さらにその先に「ultra mode」があります。両者は似て見えて役割が違います。OpenAIの公式発表の言い回しを借りると、その違いはこう表現されています——「Maxは1つのエージェントの推論を深める。Ultraは複数のエージェントに作業を振り分ける」。
- max:1つのAIに、いつもより長く粘って考えさせる。代替案を探し、自分でチェックし、途中で方針を直す。「1人の専門家にじっくり熟考してもらう」イメージ。
- ultra mode:既定で複数(4つ)のエージェントを並行して動かし、作業を分担させて最後に統合する。「チームで手分けして一気に片づける」イメージ。
Solはこうした深い設定と相性が良く、最上位モデルの実力を引き出す土台になります。ただし注意点があります。深く考えるほど、並列で動かすほど、消費するトークン(=コストと待ち時間)は増えます。速さと引き換えに精度を取りにいく設定なので、「軽い作業にmaxやultraを常用する」のは典型的な過剰投資です。なお、ultra modeの内部の動き方については表現が割れている部分もあるため、ここでは「複数のエージェントを並列で協調させる最上位設定」という理解にとどめておけば十分です。
Opus 4.8など他モデルとの性能比較は「領域依存」と考える
Solを検討していると、必ず「Claude Opus 4.8などと比べてどちらが上か」という比較が気になります。ここは正直に書きます。現時点で、どちらが一方的に優れているとは言えません。
理由は2つあります。1つは、公表されているベンチマーク(性能テスト)の数値が出典によって食い違っていること。あるテストではSolが優位、別の測定では他モデルが上、という具合に結果が割れています。もう1つは、AIの得意分野は作業の種類によって変わる(領域依存)ことです。設計や長文執筆で強いモデルと、精密な実行や反復で強いモデルは、必ずしも一致しません。
ですので、この記事では特定のベンチマーク数値を「Solが○点で勝った」といった形で断定はしません。中小企業の意思決定に必要なのは、順位表の暗記ではなく「自社の業務で試して、どちらが使いやすいかを見る」という姿勢です。前世代(GPT-5.5とClaude Opus)での比較の考え方は、下記が参考になります。

自社で比較する場合、大掛かりな検証は必要ありません。次のような簡単な進め方で十分です。
- 普段よく発生する業務を1つ選び、同じ指示文をSolと比較対象のモデルの両方に投げる
- 出力を並べて、事実関係の正確さ・抜け漏れ・読みやすさを見比べる
- 数回繰り返して傾向を見る(1回だけでは、たまたまの結果を判断材料にしてしまう)
この程度の検証であれば、追加コストも数百円〜数千円程度に収まります。順位表を探す時間より、この検証にかける時間のほうが、自社にとっては確実な判断材料になります。
中小企業・非エンジニアがGPT-5.6 Solをどう使うか
ここまでを踏まえ、中小企業の現場でSolをどう位置づけるかを具体化します。ポイントは、Solを「主役」ではなく「切り札」として持つことです。
1. 普段はTerra/Luna、勝負どころだけSol
おすすめの組み立ては、日常業務の8割をTerraかLunaで回し、Solは「大量資料の一括分析」「重要な契約書チェック」「新しい業務ツールの設計」といった月に数回の勝負どころだけに使う形です。仮に日常処理をすべてSol(出力$30.00)で回していたものをLuna(出力$1.20)に切り替えるだけで、その部分のコストは理屈上25分の1になります。「全部を最上位で」ではなく「用途で選び分ける」ことが、そのままコスト最適化になります。
2. まず1業務から、従量課金は小さく試す
APIで従量課金を使う場合、いきなり全社展開すると「想定外の請求」が起きがちです。最初は1つの業務に絞り、少額の予算上限を決めて回し、実際にかかった費用を見てから広げる。この順番なら、Solのコストが自社にとって釣り合うかを、痛手のない範囲で判断できます。
3. モデルの切り替え自体は難しくない
「Sol・Terra・Lunaを使い分ける」と聞くと複雑に感じるかもしれませんが、ChatGPT上での操作自体は、画面上部のモデル選択メニューから候補を選ぶだけです。前述のとおり選べる候補は契約プランによって変わりますが、操作自体に専門知識は必要ありません。難しいのは「どの作業にどのモデルを割り当てるか」という判断の部分であり、そこは本記事で整理した基準を目安にしていただければ十分です。
4. 「精密実行役」として司令塔の下で使う
私自身の実務での落としどころも紹介します。私は今、設計や文章づくりが得意なClaude系のAIを「司令塔(メインの頭脳)」に据え、その指示を精密に実行する役割としてGPT-5.6を呼び出す形に落ち着いています。抽象的な指示を構造に落とし込むのは司令塔役に任せ、決まった手順を正確に・反復して実行する部分でSolやCodexの実行力を活かす、という分担です。
この「設計・文章はこちら、精密な実行・反復はあちら」という役割分担の発想は、非エンジニアの方が複数のAIを使い分けるときの実用的な地図になります。Solはそのなかでもとりわけ「重い実行を任せられる切り札」という位置づけです。モデル名そのものを覚える必要はなく、「難しくて重い作業だけ、いちばん強い実行役に振る」とだけ捉えておけば十分です。
よくある質問
Q. 「gpt5.6 sol」と「GPT-5.6 Sol」は同じものですか?
はい、同じモデルを指しています。検索や会話では「GPT-5.6 Sol」「gpt5.6 sol」「5.6sol」のようにスペースの有無や表記が揺れますが、いずれもOpenAIのGPT-5.6ファミリーにおける最上位モデル(フラッグシップ)を指す表記です。本記事ではOpenAI公式表記に合わせて「GPT-5.6 Sol」と書いています。
Q. 5.6sol とは、一言で言うと何ですか?
GPT-5.6という2026年7月に登場したモデル群のうち、最も複雑で難しい作業に対応できる最上位モデルです。同じGPT-5.6ファミリーには、バランス型のTerra、最速・最安のLunaがあり、Sol(5.6sol)はその頂点にあたります。
Q. チャットGPTで「5.6sol」を使うにはどうすればいいですか?
ChatGPTの画面上でモデルを選ぶ形になりますが、選べるモデルは契約しているプランによって異なります。前述のとおり、Solのような最上位モデルは上位プランでないと選択肢に出てこないことがあります。「チャットGPTで5.6solが選べない」という場合は、まず契約プランを確認してください。
Q. Sol・Terra・Lunaのどれを最初に試せばいいですか?
迷ったらTerraから試すのがおすすめです。日常業務の大半はTerraで足り、精度が足りないと感じた作業だけをSolに切り替える、という順番が無駄のない試し方です。詳しい使い分けは前述の「Sol・Terra・Lunaの使い分け」をご覧ください。
Q. Solと他社の最上位モデル(Opusなど)はどちらが良いですか?
前述のとおり、現時点で一方が一方的に優れているとは言えません。ベンチマークの結果は出典によって割れ、得意分野も作業の種類によって変わります。順位表を探すより、自社の業務で両方を小さく試して比べるほうが、実務では確実です。
Q. GPT-5.6 Solは無料で使えますか?
最上位モデルがどのプランから使えるかは、OpenAI側の提供条件が変わることがあります。本記事では断定せず、契約前にOpenAIの公式プラン一覧でご確認いただくことをおすすめします。業務で継続的に使うのであれば、ChatGPTの有料プラン、またはAPIの従量課金のいずれかを選ぶことになります。どちらが向いているかは「定額で気軽に試す」か「システムに組み込んで従量で回す」かで判断してください。
まとめ|GPT-5.6 Solは「切り札」として持つ
GPT-5.6 Solは、3ティアの最上位に立つフラッグシップモデルです。複雑で長時間かかる作業、失敗が許されない作業でこそ真価を発揮し、max reasoningやultra modeといった深い設定とも相性よく組み合わせられます。一方で価格はファミリー最上位(出力でLunaの25倍)であり、日常業務に常用するのは過剰投資になりがちです。
他モデルとの優劣は領域や測定条件で割れるため、一方的な順位付けに頼らず、自社の業務で小さく試して見極めるのが現実的です。私たちが中小企業に伝えているのは、いつもシンプルな原則です——普段はTerra/Lunaで軽く回し、Solは勝負どころの切り札として持つ。この使い分けができれば、最上位モデルの実力を、無駄なコストをかけずに引き出せます。前述のTerra・Lunaとの役割分担、料金シミュレーション、3つの自己チェックを目安にすれば、「とりあえず一番高いモデル」を選ぶ必要はなくなります。
後継となるGPT-6 Astraが2026年9月3日に発表されました。使えるプラン・API料金・前世代からの変更点はこちらで整理しています。
関連記事
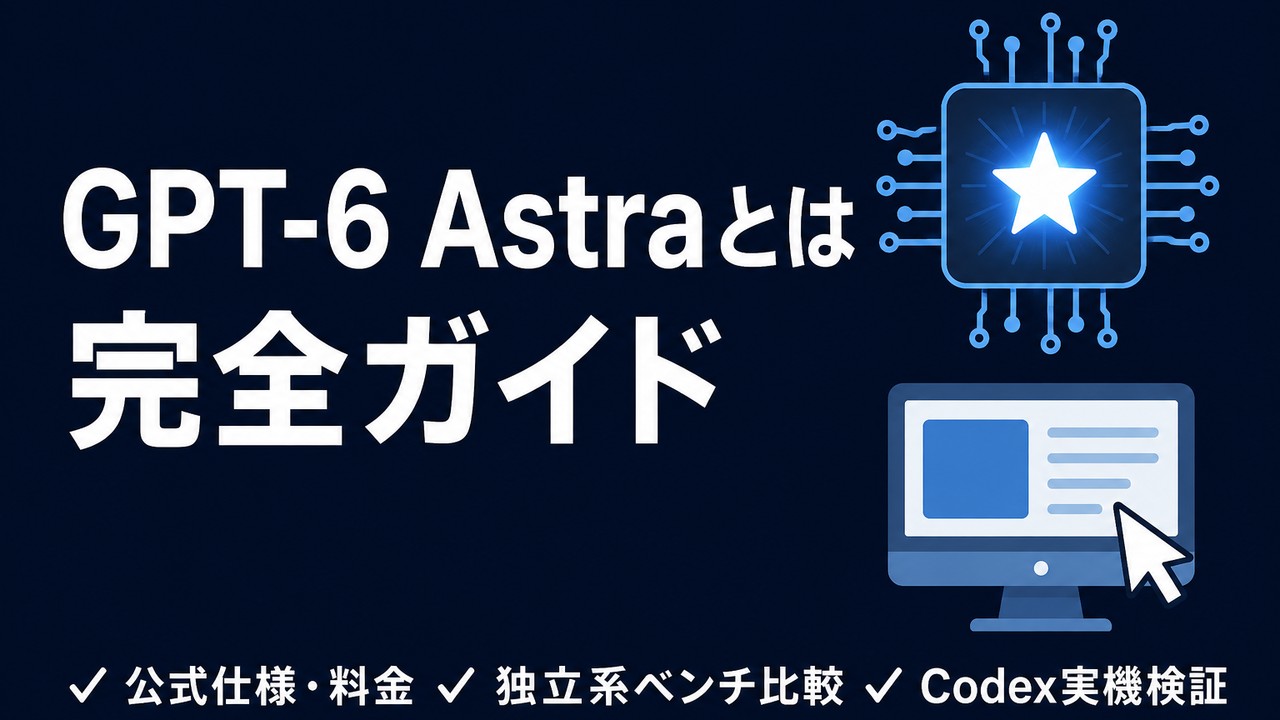
Opus 5 × GPT-5.6 Sol 徹底比較

同じ仕事を5つやらせて実測した、どの仕事をどちらに任せるかの全記録(全33ページ)
公表ベンチマークにはまだ Opus 5 の数字がありません。だから載るのを待たず、両モデルに同じ依頼を5つ投げて、時間・トークン・費用を全部記録しました。成果物のスクリーンショットも数字も、すべてそのまま載せています。
- LP/CSV集計/営業スライド/3D/請求書の5番勝負を全公開
- 同じ満点でも費用が最大4.4倍違う——その理由の分解
- 仕事別「どちらに任せるか」の早見表と判断フロー
- 自分で測るコピペ手順と、数字を4倍ズラす2つの罠
メールアドレス登録で他にも様々な資料を閲覧できます
 +8
PDF 17点・合計440ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたCodex導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。