security-audit-skillとは|6段階と使う条件

「AIにコードのセキュリティ監査をやらせたら、それらしい指摘が大量に出てきた。どれが本物なのか分からない」「話題のスキルを入れれば、自社のコードは安全になるのだろうか」——AIにセキュリティを見てもらおうとしたとき、多くの人がこの壁にぶつかります。
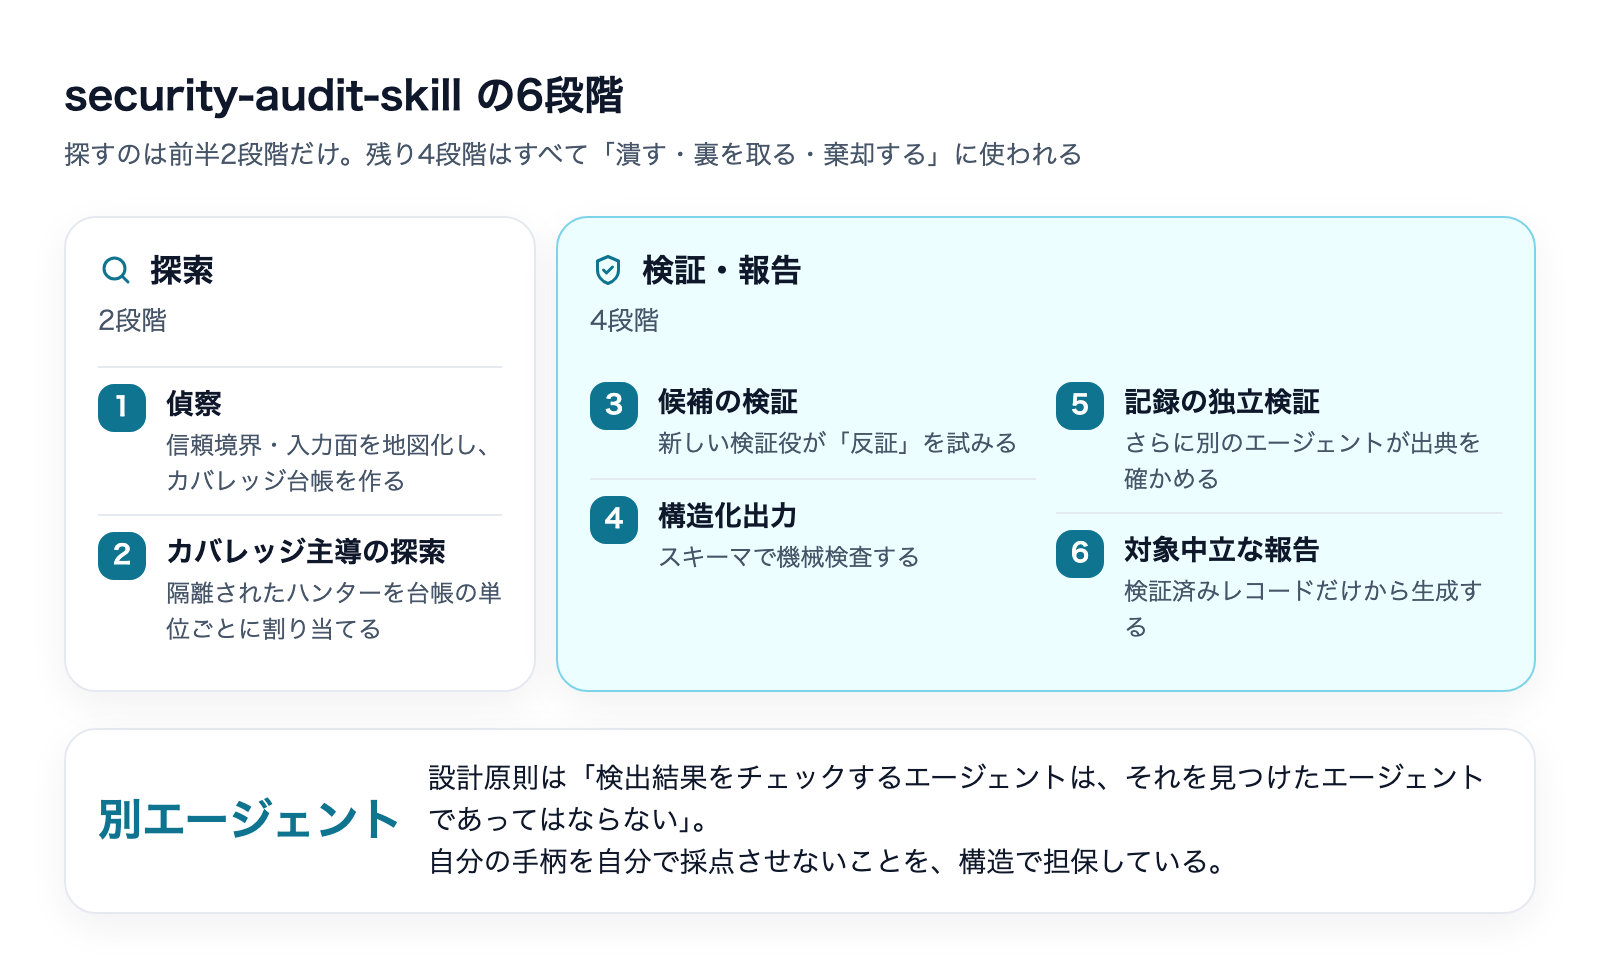
結論から言うと、Cloudflareが公開した security-audit-skill の本質は「脆弱性を見つける力」ではなく、AIが「見つけた」と言い張るのを止める仕組みにあります。6つの段階のうち、探すために使われるのは前半2つだけです。残り4段階はすべて、候補を潰し・裏を取り・棄却するために割かれています。
株式会社Fyveは中小企業のAI業務活用を支援しており、Claude Codeをはじめとするコーディングエージェントを日々の実務で使っています。この記事では、このスキルが6段階で何をしているのか、動かすために何が必要か、そして「入れれば安全になる」という読み方がなぜ危ういのかを、公式リポジトリとCloudflare公式ブログの記述に基づいて整理します。
security-audit-skillとは——コーディングエージェントを「監査官」に変えるスキル
security-audit-skill は、Cloudflareが公開しているオープンソースのエージェント用スキルです。リポジトリ自身の説明文は「A coding-agent skill for multi-phase security audits with independently verified, machine-readable findings(独立検証済みで機械可読な検出結果を出す、多段階セキュリティ監査のためのコーディングエージェント向けスキル)」となっています。ライセンスはMITです。
2026年9月17日から18日にかけてGitHubのトレンド上位に入り、2026年9月18日時点でスター数は約12,000に達しています。「AIにセキュリティ監査をさせる」という関心の高さがそのまま数字に出た形です。
重要なのは、これがゼロから作られた実験的なスキルではないという点です。リポジトリには、これがCloudflare社内の脆弱性発見ハーネス(vulnerability discovery harness)の元になったものだと明記されています。社内のハーネスは多段階・全社規模のシステムへ成長しており、公開されているこのスキルは「そこへ育っていく前の、単一リポジトリ向けの出発点」という位置づけです。つまり、実運用を経た設計の種が公開されている、という順序になります。
もう1つの特徴はエージェント中立(agent-neutral)であることです。スキル内の用語は「Parent(実行を統括し共有状態を持つエージェント)」「Task tool(そのプラットフォームの委任・サブエージェント機構)」のように抽象化されており、特定の製品に縛られていません。Claude Codeに限らず、ツール利用と並列サブエージェントに対応したエージェントであれば動く設計です。
6段階の中身——探すのは2段階だけ、残り4段階は「潰す」
公式リポジトリが示す6段階は次のとおりです。第1〜2段階が探索、第3〜6段階が検証と報告に充てられていることが、この表を見ると一目で分かります。
段階 | 名称 | やること | 生成物 |
|---|---|---|---|
1 | Reconnaissance(偵察) | アーキテクチャ・信頼境界・入力面・過去の証跡を地図にし、カバレッジ台帳を作る |
|
2 | Coverage-led hunting(カバレッジ主導の探索) | 台帳の単位ごとに隔離されたハンターを割り当て、検査内容を記録。批評役(critic)が抜けを探す | 候補(candidate)の一覧 |
3 | Candidate validation(候補の検証) | すべての候補に新しい検証役を付け、反証を試みさせる | 生き残った候補 |
4 | Structured output(構造化出力) | confirmed / needs_validation / rejected を JSON に書き、スキーマ検証にかける |
|
5 | Independent record verification(記録の独立検証) | さらに別のエージェントが最終的な出典の主張を検証。実質的な差し替えが起きたらもう一度独立検証 | 検証済みレコード |
6 | Target-neutral reporting(対象中立な報告) | 検証済みレコードだけからレポートを生成。実環境を叩く手順は書かない |
|
この配分そのものが設計思想です。AIにコードを読ませて「怪しいところを挙げて」と頼むだけなら、第1〜2段階で終わります。実際、多くの人がAIに監査をさせるときにやっているのはここまでです。そして出てくるのが、冒頭の「それらしい指摘が大量に出てきた。どれが本物なのか分からない」という状態です。
このスキルが手間をかけているのは、その後ろ側です。設計原則のひとつは 「Adversarial validation(敵対的検証): The agent that checks a finding is never the agent that found it(検出結果をチェックするエージェントは、それを見つけたエージェントであってはならない)」 と書かれています。自分の手柄を自分で採点させない、という一点を構造で担保しています。
さらに、検証役には「正しいか確かめて」ではなく「反証を試みろ(tries to disprove it)」という向きの指示が与えられます。同じ材料でも、肯定方向に確認させるか否定方向に崩させるかで結果が変わる——ここを取り違えないようにしている点が、素朴な実装との一番の差です。
加えて、検証には validate-findings.cjs と validate-coverage-ledger.cjs という依存ゼロのバリデータが同梱されており、AIの判断だけでなく機械的なスキーマ検査も通ります。
 読者特典・無料ダウンロードClaudeのこの5つの設定、今すぐ見直した方がいい無料でダウンロード →
判定は3値——「分からない」を正式な結論として残す
検出結果は2値ではなく3値で記録されます。ここが実務上いちばん効く設計です。
判定 | 意味 | 深刻度(severity) |
|---|---|---|
| 出典の追跡が完結し、観測された結果が限定的に示せている | 付ける |
| 出典に根拠はあるが、未解決の事実が1つ具体的に残っている | 付けない |
| 反証された候補 | — |
公式の記述は needs_validation について「a specific source-grounded boundary hypothesis is blocked, not a low-confidence confirmed vulnerability(出典に根拠のある境界仮説が塞がれている状態であって、確信度の低い確定脆弱性ではない)」と明確に線を引いています。深刻度を付けない理由もここにあります。
「分からない」を格下げの確定扱いにせず、未解決の事実を名指しした保留として残す。この設計は、レポートを受け取る側の判断を大きく変えます。「中リスク5件」と並べられたときに、実は根拠が詰め切れていない項目が混ざっているのが一番困るからです。
深刻度の付け方にも歯止めがあります。原則は「Severity requires impact(深刻度には影響が要る)。Likelihood x impact, not deviation from a checklist(チェックリストからの逸脱ではなく、起こりやすさ×影響で決める)」。そして判定に迷ったときの基準として「具体的な被害を述べられないなら、その深刻度は体感より低い」と書かれています。
もう1つ、実務者にとって重要な原則が「Defense-in-depth gaps are not vulnerabilities(多層防御の欠けは脆弱性ではない)。If Layer A prevents the attack, the absence of Layer B is a hardening note(層Aが攻撃を防いでいるなら、層Bが無いことは堅牢化の注記にすぎない)」です。AIに監査をさせたときに最も量が膨らむのが、この「あったほうがいい」の指摘です。それを最初から脆弱性として数えない方針が明文化されています。
Cloudflare自身の実測——棄却率40%、そして「1回では半分」
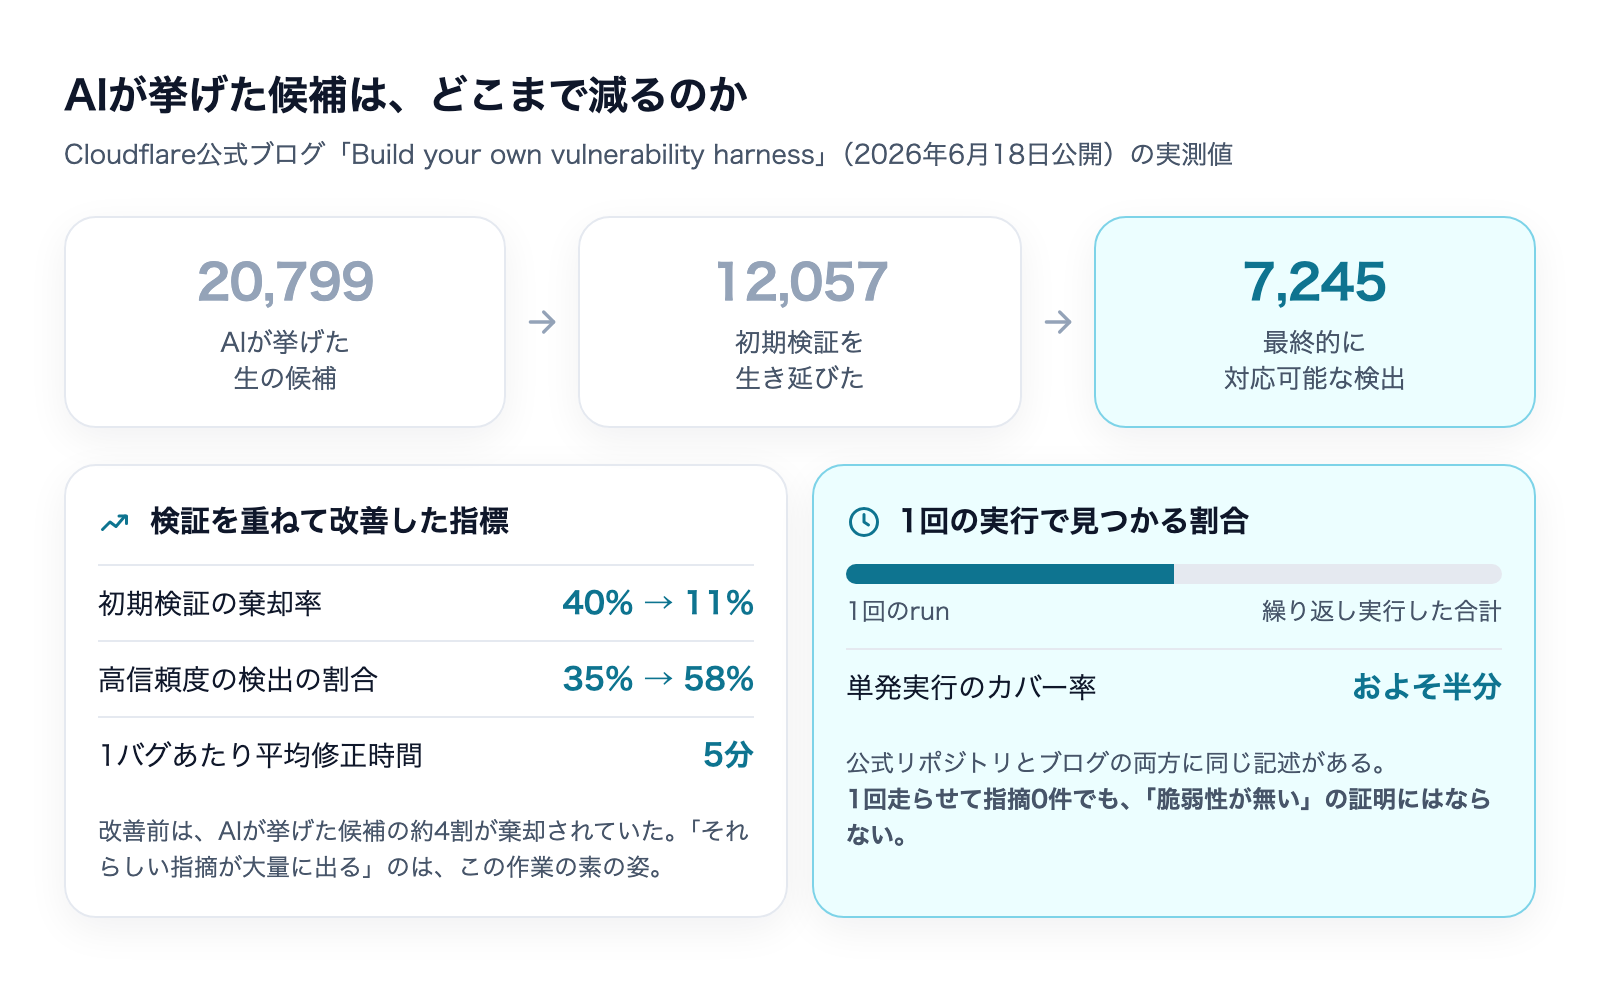
この設計がなぜ必要なのかは、Cloudflareが2026年6月18日に公開したブログ記事「Build your own vulnerability harness」(著者: Grant Bourzikas)の数字がそのまま答えになっています。公開されている社内システムの実測値は次のとおりです。
指標 | 数値 |
|---|---|
生成された候補(raw candidates) | 20,799件 |
初期検証を生き延びた候補 | 約12,057件 |
検証プールの総数(145リポジトリ) | 13,841件 |
重複として特定 | 5,442件 |
最終的に対応可能な検出 | 7,245件 |
初期検証の棄却率 | 40% → 11% に改善 |
高信頼度の検出の割合 | 35% → 58% に上昇 |
標準的なリポジトリ1本の処理 | 約100件の初期検出 → 80件の個別バグに圧縮(3〜4時間) |
1バグあたりの平均修正時間 | 5分 |
注目すべきは20,799 → 7,245 という落差です。AIが挙げた候補のうち、最終的に対応対象として残るのは3分の1程度にとどまっています。そして改善前の初期検証では候補の4割が棄却されていた。「それらしい指摘が大量に出る」のは使い方が悪いからではなく、この種の作業の素の姿だということです。
同記事は、AIによる監査で実際に起きた失敗の型も具体的に挙げています。ソースコードを自分で書き換えて攻撃を成立させ、その自作のバグを報告する/「exec() は物事を実行する、ゆえに critical」のような同語反復の「証明」を書く/まともな脅威モデルを持たないまま検出を妥当と判定する——いずれも、AIが単独で完結したときに起こる典型です。
そしてもう1つが、このスキルを使ううえで最も実務的な数字です。GitHubリポジトリ側には「In our test runs, a single run found roughly half of the vulnerabilities that repeated runs found in total(我々のテスト実行では、1回のrunは繰り返し実行して見つかった脆弱性全体のおよそ半分しか見つけなかった)」、ブログ側にも「A single run finds only about half the bugs you'd catch across multiple runs」と、ほぼ同じ内容が別々に記されています。
1回走らせて「指摘0件」だったことは、「脆弱性が無い」の証明にはならない。この点は、Claude Code標準の /security-review について私たちが整理した内容とまったく同じ構図です。単発・一度きりのチェックが何を見て何を見ないのかは、こちらで詳しく扱っています。
なお、このスキルは複数回の実行が加算的(additive)になるよう作られています。過去の台帳と検出結果を読み、抜けを狙い、変更されたソースを再検証し、現行ソースに紐づく証跡を引き継ぐ。ただし古くなった作業や未解決の作業を「カバー済み」として扱わないと明記されています。
動かすための3条件——揃わないと結論が出ない
ここが「入れれば安全になる」という読み方が崩れるところです。公式が挙げる要件は3つあります。
- 並列サブエージェントに対応したエージェント——ツール利用と、複数のサブエージェントを並行して走らせる仕組みが必要です。隔離されたハンターと新しい検証役を別々に立てる設計なので、ここが無いと6段階の骨格そのものが成立しません
- Node.js——同梱の検出結果・カバレッジ台帳バリデータを動かすために必要です
- OS が強制するサンドボックス——対象のビルド・テスト・ブラウザ・エミュレータ・ファジング等を走らせる場合に必須
3つ目の条件はかなり厳格に定義されています。外部ネットワークを遮断すること、許可リストから作られた空の環境を使うこと、対象とツールチェーンを読み取り専用にし、書き込みは割り当てられた作業ディレクトリ内だけに限ること、CPU・メモリ・プロセス数・ファイルサイズ・実行時間に明示的な上限を置くこと——これらが列挙されています。
そして「Without these controls, the workflow keeps the lead as needs_validation instead of executing target code(これらの制御が無い場合、ワークフローは対象コードを実行せず、その手がかりを needs_validation のまま保持する)」。つまり、サンドボックスが用意できない環境では、動的な確認が要る項目は確定に到達しないまま残るという設計です。黙って推測で埋めるのではなく、保留として明示する。誠実ですが、裏を返せば「手軽に入れて完全な結論が出るもの」ではありません。
実行範囲にも歯止めがあります。デプロイ済みのエンドポイント・外部サービス・共有インフラ・本番の認証情報・他人のデータを探索しないこと、有料APIの枠を消費しないこと、欠陥の存在を示すのに必要な最小限の局所的影響を超えて進まないこと。これらは両モード共通のルールとして書かれています。
2つの動作モードと3つのプロファイル
読み飛ばされがちですが、実務では効く分岐です。まずモードが2つあります。
- Guidance mode(既定)——セキュリティの質問・焦点を絞ったレビュー・手法の相談など。スキルを読み込んだだけでは6段階は走らず、出力ディレクトリも作られません
- Full audit mode——「このコードベースを監査して」「網羅的にレビューして」「レポート成果物が欲しい」と明示的に頼んだときだけ、6段階すべてが走る
どちらとも取れる依頼のときは、ファイルを作る前に1つだけ質問する設計になっています。「スキルを入れたのに何も起きない」と感じる場合、たいていは guidance mode に留まっているだけです。
Full audit mode ではさらにプロファイルを選びます。既定は standard。小さな対象や再実行向けの quick、高リスク・大規模向けの deep があります。ここで重要なのは公式の一文です——「Profiles change breadth and redundancy, never the evidence bar(プロファイルが変えるのは広さと冗長性であって、証拠の水準ではない)」。軽いプロファイルを選んでも、候補の関門・独立検証・スキーマ検証は削られません。削られるのは網羅の幅だけです。
そして範囲を絞った実行(scoped run)は「部分的なカバレッジとして自らを提示しなければならない」と定められています。範囲外は「カバー済み」ではなく out_of_scope として記録される。レポートが「全部見ました」と読めてしまう事故を、仕様で防いでいます。
コストは「エージェント呼び出し回数」で切る
AI監査の費用は読みにくいものですが、このスキルは予算を全段階を通じたエージェント呼び出し回数の上限として設定する方式を採っています。台帳の1単位がおおよそハンター1回分、生き残った候補1件が検証役1〜2回分、という数え方です。
配分の順序が独特で、探索より先に検証の枠を確保します。偵察の基本4回分、批評役の回数、そして検証役の枠(迷う場合は批評役を確保した後の残りの30%)を先に取り置き、ハンターをその予約枠に食い込ませない。予算が最低限に届かないときはエージェントを1つも起動せず、範囲を狭めるかプロファイルを粗くするかを提案する、と決められています。
さらに、すべての候補を検証しきれない場合は探索を止め、run_status: "incomplete" と理由を記録し、未検証の候補を findings.json に入れない・needs_validation に貼り替えない・完了として報告しない、と明記されています。予算が尽きたときに黙って薄めるのではなく、不完全であることを結論として出す設計です。
AI活用のコストを中小企業に説明する立場から見ると、この「検証の予算を先に取る」という順序は示唆的です。予算が足りないときに最初に削られるのは、たいてい検証の工程だからです。削った結果として出てくるのは、量は同じで信頼度だけが落ちたレポートになります。
私たちが実務で見ているところ
ここからは、コーディングエージェントを日常的に使ってきた立場からの見方です。
1つ目は、「作った本人に検証させない」という原則を自分たちの運用にも置いているかどうか。私たちはAIに何かを作らせたとき、その良し悪しの判定を同じセッションには任せず、文脈を分けた別のプロセスに渡すようにしています。同じ文脈にいるAIは、直前に自分が出した結論を前提として扱ってしまうためです。このスキルが構造として持っている「検証役は発見者と別であること」は、スキルを使わない場面でもそのまま使える原則です。
2つ目は、このスキルが見る範囲がソースコードだという前提。公式にも「Deployment controls, proxy behavior, provider settings, browser headers, identity policy...(デプロイの制御・プロキシの挙動・プロバイダ設定・ブラウザヘッダ・ID ポリシー等)は実在する制御であり、リポジトリに無い場合は在るとも無いとも仮定しない」と書かれています。
私たち自身、コードには何の問題も無いのに、外からの到達性の設定が意図どおりになっていなかった経験があります。VPN越しにしか届かないつもりだったリモート接続の口が、実際には外から直接届く状態になっていた、というものでした(発見後に塞いでいます)。これはコードをいくら読んでも出てきません。コード監査を通したことと、システムが安全であることは別の話——この線引きを、非エンジニアの経営層に説明するときに必ず添えています。
3つ目は、並列サブエージェントという要件の重さ。要件の1行目に書かれているとおり、このスキルは複数のエージェントを並行して走らせることを前提にしています。裏を返せば、その機構を持たない環境では本来の設計どおりには動きません。「無料で公開されている」ことと「自分の環境で本来の性能が出る」ことは別に確認が要ります。エージェント用スキルが「どの環境でもそのまま動く」わけではない点は、標準化の議論そのものにも関わるところです。
Claude Code側のセキュリティ機能との関係を整理しておきたい場合は、リポジトリ全体をマルチエージェントで精査する公式プラグインについてまとめた記事も参考になります。
導入手順
インストールは Skills CLI 経由の1コマンドです。
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
ユーザー単位で入れる場合は --global を付けます。エージェントの選択や非対話実行のオプションは npx skills --help で確認できます。
使うときは、監査したいコードベースの中で(またはそこを指すようにして)エージェントを起動し、依頼するだけです。公式が例示しているのは「security audit this codebase」「find security vulnerabilities in ./src」「do a security review, output to ~/audits/my-project」といった依頼文です。
出力先を指定しなかった場合、full audit mode の既定は ~/security-audit-skill/<repo-name>/run-<N> です。対象リポジトリの内部に書き込むのは、利用者が明示的にそのディレクトリを選び、かつバージョン管理から除外されていることを確認できた場合だけ、と定められています。
中小企業はこのスキルをどう扱うべきか
「無料で、大手が公開していて、GitHubで話題」という3点が揃うと、導入の判断が一足飛びになりがちです。私たちが相談を受けたときにお伝えしているのは、次の3点です。
- これは「安全になる道具」ではなく「レポートを作る道具」。出てくるのは confirmed / needs_validation / rejected に仕分けられた記録で、修正は別の作業です。スキル自身も「監査は修正方法を記述するのであって、対象のソースは変更しない」と明記しています
- 1回の実行で完了と考えない。公式の実測が「1回は全体の約半分」と言っている以上、単発の結果を「問題なし」の根拠に使えません
- サンドボックスと並列サブエージェントを用意できるか、先に確認する。揃わない場合は needs_validation が積み上がり、結局は人が判断する項目が増えます
そのうえで、このスキルは読む価値が非常に高いと考えています。仮に一度も実行しなくても、「敵対的検証」「深刻度には影響が要る」「多層防御の欠けは脆弱性ではない」「予算は検証から先に確保する」といった原則は、AIに何かを検証させるあらゆる場面に転用できるからです。実際、公開されているのはツールというより方法論のドキュメント一式で、攻撃クラス別の探索方針がドメインごとにファイル分割されています(メモリ安全性・LLMバックエンド・HTTPプロトコルと認証・クライアントサイド・サプライチェーン・クラウド構成・RPC/メッセージング・リソース枯渇・データ分離・デスクトップ/モバイル等)。
まとめ
security-audit-skill は、Cloudflareが社内の脆弱性発見ハーネスの出発点として公開した、MITライセンスのエージェント用スキルです。6段階のうち探索は2段階だけで、残りは候補を反証し・独立に検証し・スキーマで機械検査するために使われます。
設計の芯は「AIが見つけたと言うことを、そのまま信じない」。検証役は発見者と別のエージェントであること、深刻度は具体的な被害を述べられるときだけ付けること、確定できない事実は needs_validation として名指しで残すこと。Cloudflare自身の実測でも、候補20,799件のうち最終的に対応対象となったのは7,245件でした。
そして最も実務的な数字は「1回の実行では、繰り返し実行して見つかる脆弱性の約半分しか見つからない」という一文です。1回走らせて0件だったことを安全の証明として扱わない——このスキルを使うにせよ使わないにせよ、ここだけは持ち帰る価値があります。
AIをどこまで業務に任せ、どこから人が確かめるべきか。その線引きの設計は、ツールの選定よりも先に決めるべき部分です。株式会社Fyveは、その判断の材料づくりからご一緒しています。
Claudeのこの5つの設定、今すぐ見直した方がいい
共有・学習・入力・権限・委任。事故が起きるのはこの5つだけ(全28ページ)
2026年7月、Claudeの共有チャットがGoogle検索から読める状態になっていました。原因は設定そのものではなく、自分が過去に共有したものを覚えていないことでした。共有リンクの棚卸しから、学習をオフにしても残る例外条項、Claude Codeの権限モードまで、今日30分で確認できる形にまとめています。
- 見落としやすい共有リストは3つある(3つ目は画面の下)
- 学習をオフにしても残る、公式の例外条項
- 権限モード6つの違いと、Shift+Tabでの切り替え方
- 私が実際に禁止しているコマンド23行を全文公開
メールアドレス登録で他にも様々な資料を閲覧できます
 +4
PDF 13点・合計358ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。