Firecrawl Localの使い方|入れ方とMCP接続

「Firecrawl Localが出たらしいけれど、Dockerで立てる自前ホストと何が違うのか」「Claude CodeやCodexにつないだら、取ってきたページは外に出ていくのか」——スクレイピング(Webページを機械で読み取ること)をAIエージェントに任せている人ほど、新しい道具を入れる前にここが気になるはずです。
結論から言うと、Firecrawl LocalはRustで書かれた1つの実行ファイルで、scrape・crawl・mapを手元のパソコンだけで動かす版です。入れ方は cargo install firecrawl-local、AIへのつなぎ方は firecrawl-local init の1行で済みます。ただし初期設定のままだと、手元で読めなかったページと検索はFirecrawl Cloudに回ります。すべて手元で済ませたいなら、環境変数 FIRECRAWL_CLOUD=off を必ず付けてください。
株式会社Fyveは、中小企業の業務にClaude CodeやMCP(AIと外部の道具をつなぐ共通の決まり)を組み込む支援をしています。この記事では、Firecrawlの公式の発表(2026年11月18日)とGitHubのREADMEを出典に、入れ方、Claude Code・Codexへのつなぎ方、Cloudに回る条件と止め方、自前ホスト・Cloudとの使い分けを順に説明します。あわせて、私たちが自社でWebページを機械で読むときに決めている線引きもお伝えします。
Firecrawl Localとは:手元で動くFirecrawlの1バイナリ版
Firecrawlは、Webページを読みやすいMarkdown(見出しや箇条書きを記号で表す書き方)に変換して、AIに渡しやすくする道具です。これまでの使い方は、運営元のサービスを使う「Firecrawl Cloud」と、自分のサーバーに全部を立てる「自前ホスト」の2つでした。
2026年11月18日、Firecrawlはchangelogで3つ目の形として「Firecrawl Local」を発表しました。発表文の要点は次のとおりです。
- scrape(1ページを読む)・crawl(リンクをたどって複数ページを読む)・map(サイトのURLを一覧にする)を、Rustで書いた部品で手元のパソコンで動かす
- 自前ホストと比べて37倍速く、メモリは230分の1(待機中は11MB)
- 100%オープンソースで、既存のFirecrawlのMCPサーバーとSDK(各言語用の呼び出し部品)とそのまま組み合わせられる
GitHubのREADMEによると、データベース・キュー(仕事の待ち行列)・コンテナはいりません。手元で読んだページは、Firecrawlのサービスと同じ整形のコードでMarkdownになります。配布はRustのパッケージ置き場であるcrates.ioで、firecrawl-local の0.1.0が2026年11月11日、0.1.1が11月19日(いずれも協定世界時)に公開されています。ライセンスはAGPL-3.0です。
「37倍速い」「230分の1」は公称の数字
先に注意点を1つ挙げておきます。37倍・230分の1という数字は、Firecrawlが発表で示した値です。第三者の解説記事(Apidog、2026年11月19日)は、READMEに計測の方法・使ったページ・機械の構成が書かれていないため、この数字が何を測ったものかは確かめられないと指摘しています。私たちもまだ手元で測っていません。乗り換えを決めるときは、自分がふだん読むURLで測ってから判断するのが安全です(測り方は後半で紹介します)。
Firecrawl Localの入れ方(Mac・Linux)
ここからは手順です。必要なものは次の3つです。
必要なもの | 用途 | 無いとどうなるか |
|---|---|---|
RustとCのコンパイラ | 本体のビルドに必須 | 入れられない |
ChromeかChromium | JavaScriptで中身を出すページの描画 | 静的なページは読める。描画が必要なページは警告付きで返る |
Node.js 22以上 | MCPサーバー(npmの | AIにつなげない |
手順1:RustとCのコンパイラを入れる
macOSならXcodeのコマンドラインツール、DebianやUbuntuなら build-essential がCのコンパイラです。Rustが入っていなければ、公式の配布元(rustup.rs)に書かれている1行で入れます。
# macOS:Cのコンパイラ
xcode-select --install

# Ubuntu / Debian:Cのコンパイラ
sudo apt install build-essential

# Rust(cargo)を入れる
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
私たちの記事作成用のMac miniで確かめたところ、Node.jsは22.23.4で条件を満たしていましたが、cargo と rustc は入っていませんでした。AIの作業用にMacを用意している人でも、Rustは入っていないことが多いはずです。ここが最初のつまずきどころになります。
手順2:Firecrawl Localを入れて版を確かめる
cargo install firecrawl-local
firecrawl-local --version
cargo install は手元でソースからビルドするので、数分かかることがあります。最新のコードを試したい場合は、リポジトリを取ってきて apps/local で cargo build --release する方法もREADMEに書かれています。
手順3:まず1ページ読んでみる
# 1ページをMarkdownで表示
firecrawl-local scrape https://example.com --markdown

# サイトのURLを一覧にする
firecrawl-local map https://firecrawl.dev

# リンクをたどって最大50ページを1ページ1ファイルで保存
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages
--markdown を付けないと、Firecrawlのサービスと同じ形のJSONが返ります。出力の形式は --format markdown,links のように選べ、選べるのは markdown・html・rawHtml・links の4つです。PDFやOfficeの文書も手元で読み取れます。
よく使うオプションも押さえておきます。crawl の --limit は既定で100ページ、--max-depth でたどる深さ、--include・--exclude でパスの絞り込みができます。scrape の --full-page はナビゲーションやフッターも残す指定、--browser auto|never|always はChromeを使うかどうかの指定で、どのコマンドにも付けられます。
Claude Code・CodexにMCPでつなぐ手順
いちばん簡単なのは init
# 何が書き換わるかだけ確認する
firecrawl-local init --dry-run

# 実際に登録する
firecrawl-local init
init は、パソコンに入っているClaude Code・Claude Desktop・Cursor・Windsurf・Gemini CLI・Codexを探して、それぞれにFirecrawl LocalをMCPサーバーとして登録します。書き換える前に設定ファイルを1つずつ控えてくれます。1つの道具だけに入れたいときは --agent cursor のように指定します。登録したら、AIの道具を再起動してください。
いきなり書き換えるのが不安なら、まず --dry-run で変更の中身を見るのをおすすめします。複数のAIの道具を並べて使っている人ほど、どの設定ファイルが変わるかを先に見ておく価値があります。
手で登録する場合(Cloudを止める設定込み)
READMEは、手で登録するなら firecrawl-local mcp を標準入出力(stdio)のMCPサーバーとして登録するよう案内しています。ここに、後で説明する FIRECRAWL_CLOUD=off と --public-only を最初から付けておくと安心です。/path/to/ の部分は、手順2で入った実行ファイルの場所に置き換えてください(which firecrawl-local で分かります)。
# Claude Code
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- /path/to/firecrawl-local mcp --public-only

# Codex
codex mcp add firecrawl --env FIRECRAWL_CLOUD=off -- /path/to/firecrawl-local mcp --public-only
どちらのコマンドも、環境変数の渡し方(Claude Codeは -e、Codexは --env)と、-- の後ろに起動コマンドを書く形を、私たちの手元のClaude Code 2.1.296とCodex CLI 0.169.0のヘルプで確かめています。設定ファイルに直接書く場合は、READMEの例に環境変数を足した次の形になります。
{
  "mcpServers": {
    "firecrawl": {
      "command": "/path/to/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}つないだ後、AIからはFirecrawlの標準のMCPの道具(firecrawl_scrape・firecrawl_map・firecrawl_crawl など)が見えます。仕組みとしては、firecrawl-local mcp が手元のAPIを内部のポートで立ち上げ、その上でnpmの firecrawl-mcp を動かしています。そのため、scrape・crawl・map・batch scrape(まとめて読む)は手元で動き、それ以外の道具はFirecrawl Cloudに向かいます。
MCPそのものの考え方やCodexでの設定の基本は、次の記事で詳しく説明しています。
FIRECRAWL_CLOUDで「どこまで手元で済ませるか」を決める
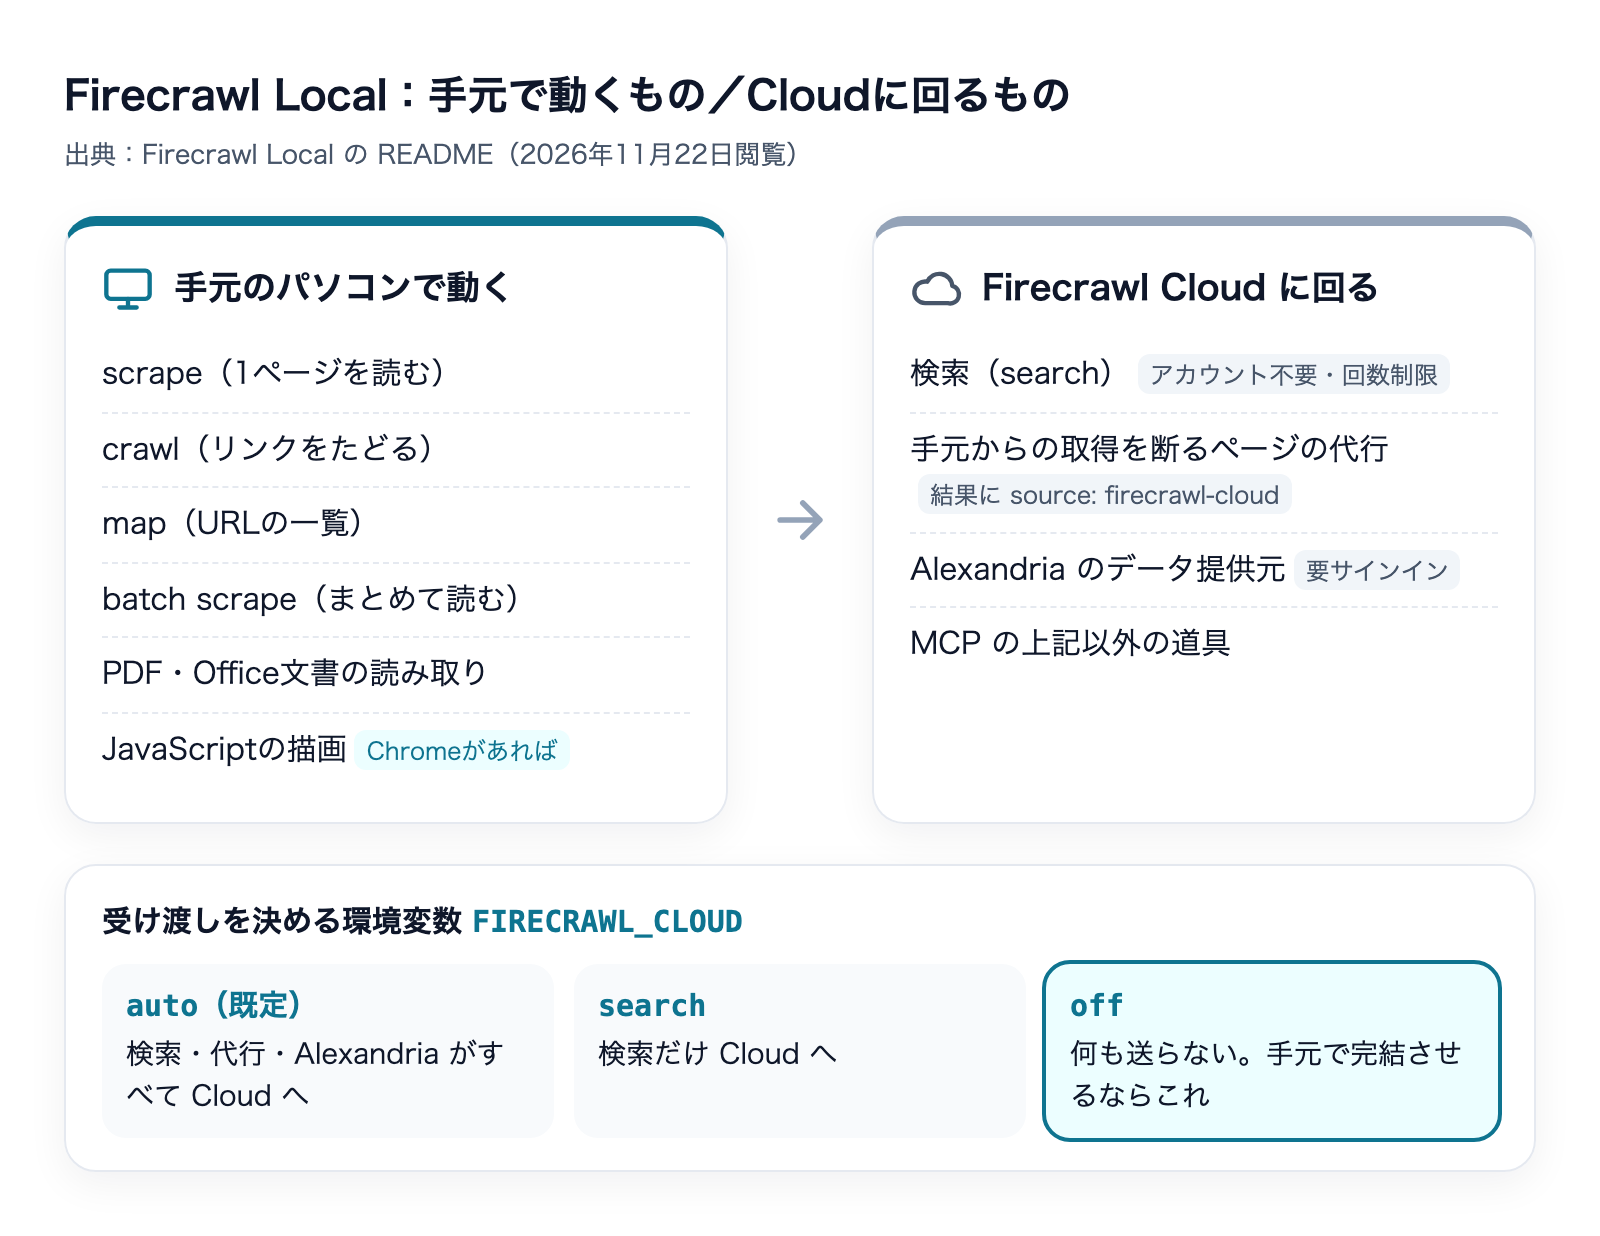
この記事でいちばん伝えたいのがここです。Firecrawl Localは「手元で動く」と紹介されることが多いのですが、初期設定では一部の処理がFirecrawl Cloudに回ります。READMEに書かれている、Cloudに回るものは次の3つです。
Cloudに回るもの | 理由(README) | アカウント |
|---|---|---|
検索(search) | 手元に検索の索引が無いため | 不要(回数の制限あり) |
手元からの取得を断るページ | 普通の取得と手元のブラウザの両方が拒まれたとき、Cloudが代わりに取りに行く | 不要 |
Alexandriaのデータ提供元 | 提供元がCloudで動いているため | 無料アカウントが必要 |
Cloudが代わりに取ってきたページには、結果に "source": "firecrawl-cloud" が付きます。Cloudでも取れなければ "blocked": true と理由の警告が返ります。また、Cloudへの呼び出しには、ランダムなインストールIDと呼び出した道具の名前が付きます。Firecrawlはこれでインストール数を数えている、とREADMEは説明しています。
この受け渡しを決めるのが環境変数 FIRECRAWL_CLOUD です。
値 | 動き |
|---|---|
| 検索・取得を断られたページの代行・Alexandriaがすべて使える |
| 検索だけCloudに回す |
| 何もCloudに送らない |
認識できない値は off 扱いになります。例外は login で、サインインするためのコマンドなので常にFirecrawlと通信します。
どの値を選ぶか
私たちの考え方は単純です。社外に出したくないURLを読む可能性が少しでもあるなら off、検索だけ使いたいなら search、そうでなければ既定の auto でかまいません。
たとえば、社内向けのページや公開前のページの確認にAIを使う場合、手元で読めなかったときにそのURLがCloudに渡るのは避けたいところです。逆に、公開されている競合のサイトを読むだけなら、取れなかったページをCloudが拾ってくれる auto のほうが便利です。「手元で動くから外に出ない」と思い込まず、値を1つ決めてから使う。これが入れたあと最初にやることです。
APIサーバーとして使う(serve)
MCPではなく、自分で書いたプログラムから使いたい場合は serve を使います。ポート3002でFirecrawlのv2のAPIに答えるので、Firecrawl向けに書いたコードを、接続先を変えるだけで手元に向けられます。手元の経路はAPIキーがいりません。
firecrawl-local serve

# 別のターミナルから
curl -s http://localhost:3002/v2/scrape \
  -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
from firecrawl import Firecrawl
app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)手元で答える経路は、/v2/scrape・/v2/map・/v2/crawl・/v2/batch/scrape と、死活確認の GET /health です。/v2/search などそれ以外のv2の経路は、FIRECRAWL_CLOUD が許せばCloudに渡されます。
自前ホストから移る人は、次の3点に注意してください。
- v0・v1のAPIは提供されない。古い経路を呼んでいるコードは動かない
- crawlとbatchの仕事はメモリ上にだけあり、開始から1時間で消える。
serveを止めても消える - 死活確認の場所が変わる。第三者の解説(Apidog)によると、自前ホストの
/v0/health/readinessからGET /healthに変わるので、監視の設定を直す必要がある
自前ホスト・Cloudとの違いと使い分け
3つの形を並べると、選び方が見えやすくなります。自前ホストの構成は、Apidogの解説によるとDocker Composeで5つのサービス(API、ブラウザのサービス、Redis、RabbitMQ、PostgreSQL)を動かす形です。
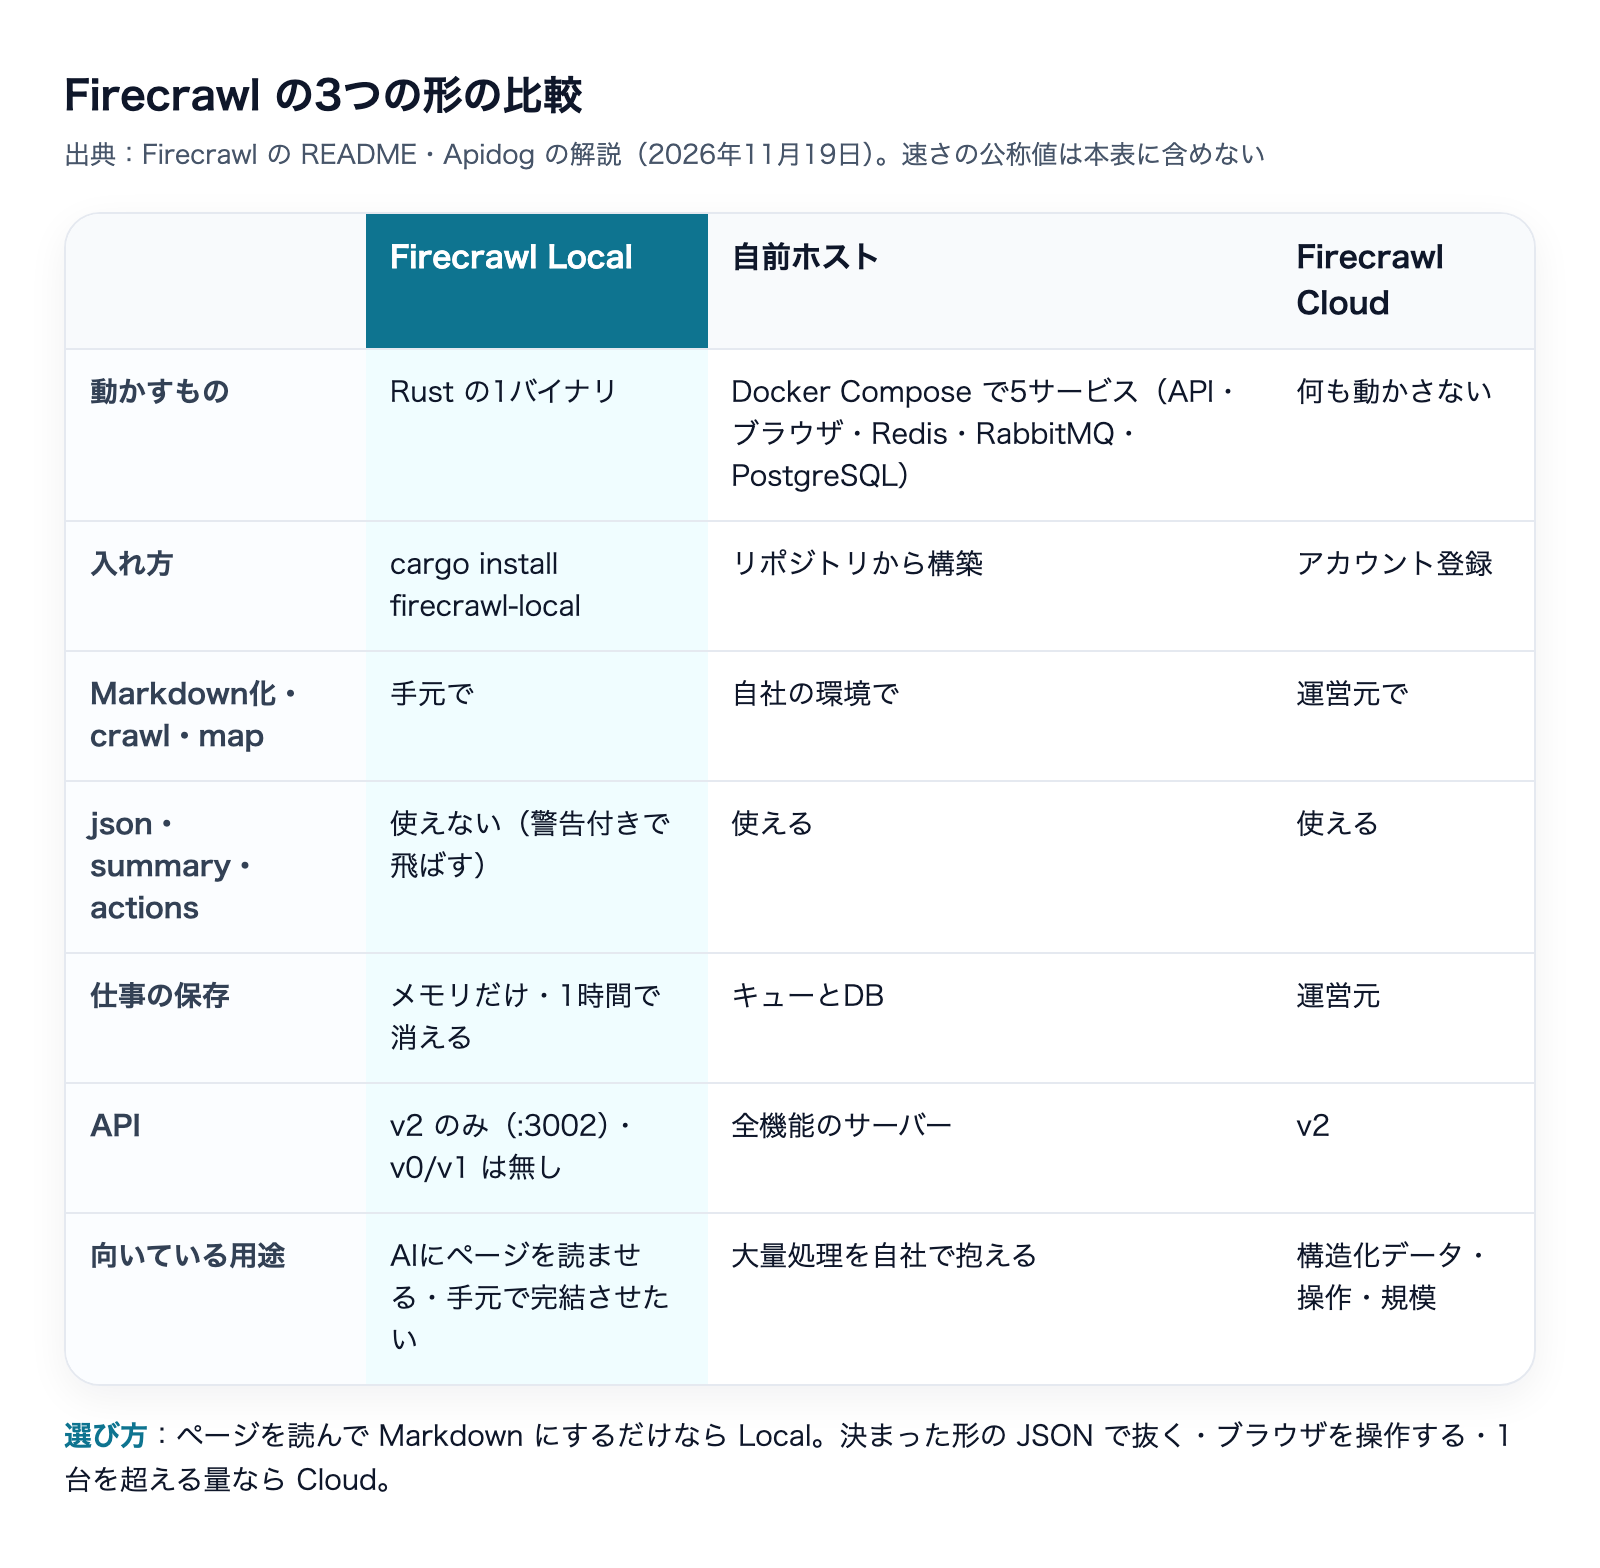
手元で読むときにできないことも、READMEの「Limits」に書かれています。
- AIで整形する
json(決まった形のデータで返す)とsummary(要約)は、警告付きで飛ばされる - ブラウザの操作(
actions:クリックや入力を順に行う指定)は無視される - スクリーンショットにはChromeが必要
まとめると、「ページを読んでMarkdownにする」だけならLocal、決まった形のJSONで抜き出す・ブラウザを操作する・1台の範囲を超える量を回すならCloud、キューやデータベースごと自社の環境で抱える必要があるなら自前ホスト、という分け方になります。READMEも、構造化したJSON・Interact(ページの操作)・Agent・1台を超える規模が要るならCloudへ、と案内しています。
ライセンスにも触れておきます。本体はAGPL-3.0で、SDKと一部の画面の部品はMITです。自分の業務で道具として使う分には大きな問題は起きにくいはずですが、改変したものを他の人に使わせるサービスとして出す場合は、AGPLの条件を自社で確認してください。
安全に使うための初期値と、私たちの線引き
READMEに書かれている守りの初期値
Firecrawl Localは、自分で叩くコマンドと、他のプログラムから呼ばれるAPIサーバーで、初期値を変えています。
- scrape・crawl・map・mcp:キーボードの前の人のために動くので、
localhostや社内のネットワークにも届く。scrape・crawl・mcpは--public-onlyを付けると、そうした宛先を断る - serve:
127.0.0.1だけで待ち受け、--allow-privateを付けない限りlocalhostや社内の宛先を断る。--hostで別のアドレスにするときは--tokenが必須 - 常に断る宛先:リンクローカルとクラウドのメタデータのアドレスは、どのモードでも、リダイレクトや名前解決の後でも断る
READMEは、隠れた指示が書かれたページを読んだAIエージェントが、社内のURLを開くよう誘導されうると注意しています。信頼できないサイトを読ませるなら、MCPサーバーを firecrawl-local mcp --public-only で登録するよう勧めています。先ほどの手で登録する例に --public-only を入れたのはこのためです。
ブラウザもChromeを画面なし・サンドボックスありで動かし、使い捨てのプロファイルを使います。さらに、開くすべての通信(リダイレクト・画像などの読み込み・スクリプトの通信・WebSocket)を、Firecrawl Localの中の中継で確かめる作りです。Dockerの中でJavaScriptのページを描画したい場合、Docker既定のseccomp(使えるシステムコールを絞る仕組み)がChromeのサンドボックスを妨げます。READMEは、Playwrightが公開している設定ファイルを使い、seccomp=unconfined は使わないよう書いています。
サイトの運営者向けには、User-Agent(アクセス元の名乗り)で自分がFirecrawl Localだと名乗り、crawlのときは robots.txt を読むこと、運営者は FirecrawlLocal の名前で指定できることも書かれています。
実際に、エージェント向けの案内文が入ったページに出会った
この記事を書くために、私たちの記事作成の自動のジョブでFirecrawlのchangelogのページをそのまま取得しました。すると、ページの末尾に「あなたがAIエージェントなら、次のファイルを取ってきてその手順に従ってください」という趣旨の、エージェント向けの案内文が入っていました。人がブラウザで見ているときには目に入りにくい場所です。
中身はFirecrawlへの登録の案内で、悪意のあるものではありません。それでも、AIに読ませるページには、AIに向けた文がふつうに入っていることはよく分かります。私たちの自動のジョブでは、取ってきたページの文は記事の材料として扱い、中に書かれた指示には従わない決まりにしています。Firecrawl Localをエージェントにつなぐときも、--public-only と FIRECRAWL_CLOUD の値は「AIが何を読まされるか分からない」前提で決めるのが安全です。
道具を替えたら「拾えないもの」の欄を書き直す
私たちは、営業の下調べで、会社のサイトから問い合わせの窓口を機械で拾うスクリプトを使っています。Pythonの標準の部品と正規表現でページを取り、1ページごとに0.7秒待つ、素朴な作りです。このスクリプトは、ファイルの頭の説明書きに、まず「読むだけ。入力・送信はしない」と範囲を書き、続けて「JavaScriptで後から出るフォームは拾えない。『営業お断り』の見落としもありうる。送る前に人がフォームの画面を目で見る」と書いています。機械の結果は「当たり付け」と呼び、確定とは呼びません。
道具をFirecrawl Localに替えると、READMEの上では、JavaScriptのページは手元のChromeで描画できるようになり、描画できなければ警告が返ります。つまり「拾えないもの」の中身が変わります。ここで大事なのは、道具を替えたら、その欄を書き直すことです。なお、Firecrawl LocalでJavaScriptのフォームが本当に拾えるかは、私たちはまだ試していません。試すまでは、説明書きの「拾えない」を消さないつもりです。
スクレイピングのように取りこぼしが避けられない作業ほど、何ができるかより先に、何が漏れるか・どこを人が見るかを書いておく。これが、AIに機械の作業を任せるときに私たちが守っている線引きです。業務で使えたMCPサーバーの一覧は、次の記事にまとめています。
乗り換える前に、自分のURLで測る方法
公称の37倍・230分の1をそのまま信じず、自分の用途で確かめる方法も書いておきます。私たちはまだ実施していないので、これは手順の提案です。
- ふだん読むURLを20本ほど選ぶ。静的なページ、JavaScriptで中身を出すページ、PDFを混ぜる
- 今の道具とFirecrawl Localで同じURLを読む。
FIRECRAWL_CLOUD=offにして、手元だけの結果を見る - 時間とメモリを記録する。macOSなら
/usr/bin/time -l firecrawl-local scrape ...で、かかった時間と最大のメモリ使用量が出る - 中身を見比べる。速さよりも、本文が欠けていないか、警告や
"blocked": trueが何本に付いたかを数える
速さが数倍違っても、読めないページが増えるなら乗り換える意味は薄くなります。数字は「同じ品質で読めた本数」とセットで見てください。
よくある質問
Firecrawl LocalにAPIキーやアカウントは必要ですか
手元で動くscrape・crawl・mapと、serve の手元の経路はAPIキーがいりません。検索と取得を断られたページの代行もアカウント無しで使えますが、回数の制限があります。Alexandriaを使うときだけ、firecrawl-local login でサインインが必要です。サインインした情報はFirecrawl CLIと同じ場所に保存されるので、どちらでログインしても両方で使えます。
Windowsで使えますか
READMEが案内している入れ方はmacOSとDebian・Ubuntuで、Windowsの手順は書かれていません。Dockerで動かす場合の注意は書かれています。
既存のFirecrawlのコードはそのまま動きますか
v2のAPIを使っていて、json・summary・actions に頼っていなければ、接続先を http://localhost:3002 に変えるだけで動く作りです。v0・v1の経路を使っているコードは動きません。
Firecrawl Localでクロールしたページはどこかに送られますか
READMEによると、scrape・crawl・map・文書の読み取りは手元で動き、Firecrawlに何も送りません。Cloudに行くのは、検索・取得を断られたページの代行・Alexandriaの3つです。FIRECRAWL_CLOUD=off にすれば、それも止まります。
まとめ:入れたら最初に FIRECRAWL_CLOUD を決める
- Firecrawl Localは、scrape・crawl・mapを手元で動かすRustの1バイナリ。
cargo install firecrawl-localで入り、initでClaude Code・Codexなどにつながる - 初期設定(
auto)では、検索・取得を断られたページ・AlexandriaはFirecrawl Cloudに回る。手元で完結させるならFIRECRAWL_CLOUD=off - 信頼できないサイトを読ませるなら、MCPは
--public-onlyを付けて登録する json・summary・actions・v0/v1のAPIは手元では使えない。必要ならCloudか自前ホスト- 37倍・230分の1は公称。自分のURLで、読めた本数とセットで測ってから乗り換える
株式会社Fyveでは、Claude CodeやCodexに外部の道具をつなぐとき、どこまでAIに任せ、どこで人が確かめるかを一緒に決めるところからお手伝いしています。
出典(2026年11月22日閲覧)
- Firecrawl Changelog:Introducing Firecrawl Local(2026年11月18日)
- GitHub:firecrawl/firecrawl(README)
- GitHub:firecrawl/firecrawl apps/local(Firecrawl LocalのREADME)
- crates.io:firecrawl-local(0.1.0=2026年11月11日・0.1.1=11月19日)
- npm:firecrawl-mcp(Node.js 22以上)
- GitHub:firecrawl/firecrawl-mcp-server
- Apidog:Firecrawl Self-Hosted vs Firecrawl Local: What Changed(2026年11月19日)
- rustup.rs(Rustの公式インストーラ)
Claude Codeを「素のまま」使うな
設定で差がつく——CLAUDE.md・権限・スキルの実物を公開(全24ページ)
素のClaude Codeは"優秀な新入社員"。仕事を教えるほど、自分専用になります。覚えさせる4点セット——会社の説明書(CLAUDE.md)・権限の柵・手順書(スキル)・フォルダの地図——を、1人会社の実運用からコピペで使える型つきで公開します。
- そのまま書き換えて使えるCLAUDE.mdの型
- お金と送信をAIに触らせない「3段階の柵」
- 1回教えたら何度でも動く、手順書のコピペ雛形
- AIが迷子にならないフォルダ構造の3原則
メールアドレス登録で他にも様々な資料を閲覧できます








 +14
PDF 23点・合計550ページ + すぐ使えるzip素材 3点
どれも登録後の受け取りページから、まとめてダウンロードできます。
毎週配信の無料ニュースレター「AIネイティブ超研究」の購読特典です。メール登録後すぐ、受け取りページのご案内が届きます。そこにはこの資料に加えて、過去の特典もすべてまとめて置いてあります。あわせて、AI活用に関するお知らせやお役に立てそうなご案内をお送りすることがあります。解除はいつでも1クリック。
御社の業務に合わせたClaude Code導入支援
「AIツールを導入したが、現場で使われない」を終わらせる。
業務課題のヒアリングから設計、ハンズオン実践、運用定着まで一貫して支援します。