「自分のサイトの記事を、AIの学習には使ってほしくない。でも検索やAIの回答からは消えたくない」「robots.txtにGPTBotを1社ずつ書き足すのはもう限界」——自社サイトを運営していると、AIの学習の扱いをどう書けばいいのか迷うはずです。
結論から言うと、2026年11月1日時点でrobots.txtに書くなら、User-Agent: __usage_ai-training のグループに Disallow: / を足す書き方がいちばん効く見込みがあります。2026年10月30日に、GoogleとMicrosoftがこの書き方への対応時期を公式に出し、OpenAIも共通の合図に従うと発表しました。ただし、どの会社もまだ読み始めていません。今までの GPTBot や Google-Extended の指定は消さずに残してください。
株式会社Fyveは、中小企業のAI導入とAI検索対策を支援しています。この記事では、IETF(インターネットの技術標準を決める団体)の草案の原文と各社の公式発表だけを根拠に、robots.txtでAIの学習を断る書き方を整理します。似た名前の書き方が2つあって、どちらを書けばいいかが分かりにくいので、その違いも説明します。
先に答え:今robots.txtに足すのはこの4行
サイト全体でAIの学習を断りたいだけなら、今のrobots.txtの末尾に次のグループを足します。既にある行は消しません。
# AIの学習に使わないでほしい(共通の合図・2026-10-30の草案)
User-Agent: __usage_ai-training
Disallow: /

# 今までの各社ごとの指定(対応が始まるまではこちらが効く)
User-Agent: GPTBot
Disallow: /

User-Agent: Google-Extended
Disallow: /
やっていることは次の3つです。
- 1つ目のグループ:各社が共通で読む予定の合図。「このサイトの中身を生成AIの学習に使わないでほしい」という希望を1か所で示します
- 2つ目と3つ目のグループ:OpenAI(GPTBot)とGoogle(Google-Extended)が今読んでいる指定。共通の合図への対応が始まるのはGoogleが2027年初め、Microsoftが2027年2月1日なので、それまではこちらが実際に効きます
- 検索の指定には触れない:
User-Agent: *や Googlebot、OAI-SearchBot の行はそのまま。Google検索やChatGPTの検索からは消えません
以下で、なぜこの形になるのか、別の書き方の Content-Usage と何が違うのかを順に説明します。
2026年10月30日に何が出たのか
同じ日に、AIの学習の合図についての発表が4つ重なりました。出典の強さが違うので、表では分けて書いています。
出どころ | 何を言ったか | 読み始める時期 | 根拠 |
|---|---|---|---|
IETFの個人の草案 |
| —(仕様そのもの) | 草案の原文(2026-10-30付) |
「AIPREFの共通の学習の合図( | 2027年初め | Google検索セントラルのクローラー一覧(2026-10-30更新) | |
Microsoft(Bing) |
| 2027年2月1日 | Bing公式ブログ(2026-10-30) |
OpenAI | AIの学習の希望をrobots.txtで示す共通の合図に従う。今の GPTBot などの指定はそのまま残す | 「今後数か月」・実装の詳細は後日 | OpenAI公式ブログの題名と日付(RSS)+二次の報道2本。本文は自動取得を拒否されて読めず |
大事なのは、GoogleとMicrosoftは書き方まで __usage_ai-training と名指ししていることです。OpenAIは「共通の合図に従う」とまでは言っていますが、私が読めた範囲では書き方の名前を出していません。報道もそこは推測で補っているものが多いので、OpenAIについては「対応すると言った・時期と方式の詳細はこれから」と受け取るのが正確です。
もう1点。報道には「Anthropicも対応」と書いたものが多くありますが、11月1日時点でAnthropicの公式ニュースに対応の発表は見当たりませんでした。草案の著者がAnthropicの所属というだけで、会社として何をいつ読むかは確認できていません。
似た書き方が2つある:Content-UsageとUser-Agentの方式
ここが一番混乱しやすいところです。IETFのAI Preferences作業部会(aipref)には、robots.txtで学習の希望を示す方法が2系統あります。
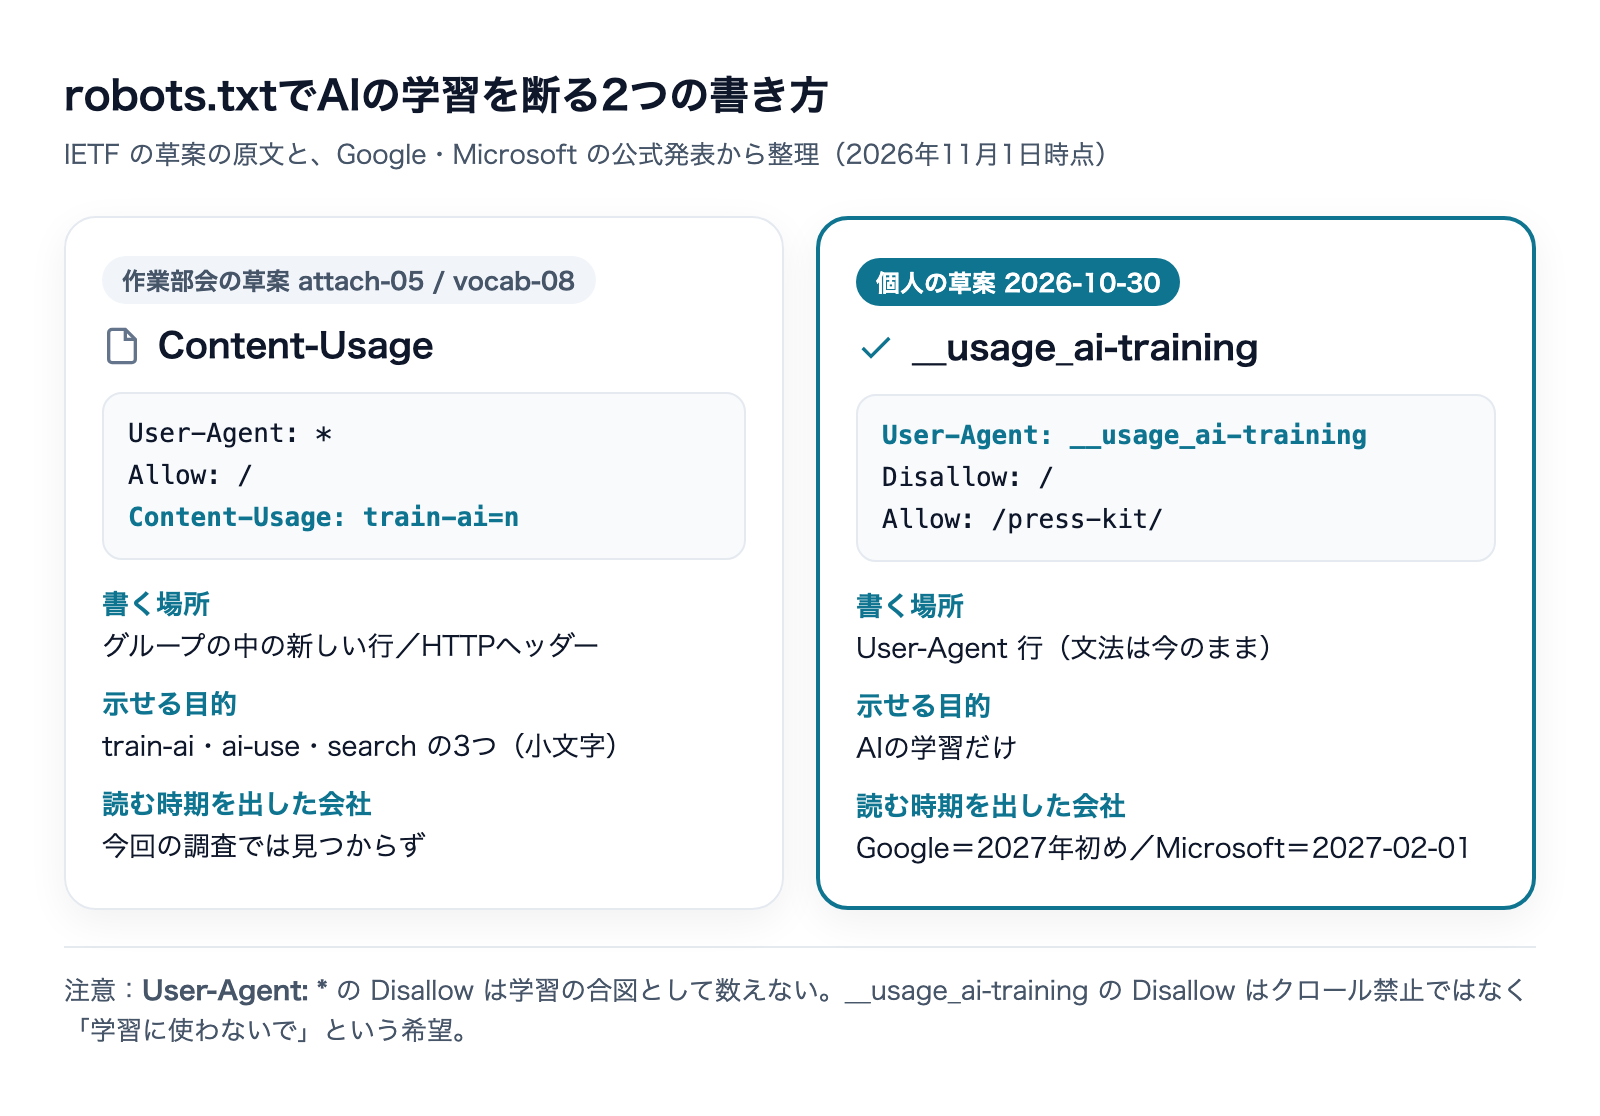
Content-Usage(作業部会の草案・2026年8〜9月)
作業部会として出している草案(attach-05・2026-08-19/vocab-08・2026-09-14)の書き方です。robots.txtのグループの中に、新しい行 Content-Usage: を足します。
User-Agent: *
Allow: /
Content-Usage: train-ai=n
決まりは次のとおりです(いずれも草案の原文から)。
- 使える項目は3つ:
train-ai(AIの学習)・ai-use(AIへの入力として使う)・search(検索)。値はy(よい)かn(使わないで) - 小文字で書く:大文字と小文字を区別します。
Train-AI=nのように大文字が混じると読み取りに失敗し、希望は「不明」として扱われます - 道ごとにも書ける:
Content-Usage: /ai-ok/ train-ai=yのように、前に道(パス)を置くとその下だけに効きます - クロールを止めた道には効かない:Disallow で取得を禁じた道には、希望そのものが付きません
- 食い違ったら厳しいほう:同じ道に「よい」と「使わないで」があれば「使わないで」になります。Allow/Disallow の食い違いが「許すほう」になるのとは逆です
- 同じHTTPヘッダーも送れる:
Content-Usage: train-ai=nをレスポンスのヘッダーに付けても同じ意味になります
筋は通っていて、ヘッダーでもrobots.txtでも書ける汎用の仕組みです。ただし、語彙の草案には「この文書の内容は作業部会の合意を反映していない」と大きく書かれています。今回調べた範囲で、この書き方を「いつから読む」と約束した会社は見つかりませんでした。
User-Agent: __usage_ai-training(個人の草案・2026年10月30日)
10月30日に出た個人の草案の書き方です。新しい行は足さず、User-Agent の行に「目的の名前」を書くだけです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
この例は「/press-kit/ の下は学習に使ってよい、それ以外は使わないでほしい」という意味になります。草案の決まりで、押さえておくべきものは4つです。
User-Agent: *は当たらない:草案は「ワイルドカードのグループをこの名前に当てはめてはならない」と定めています。つまり、全体向けのDisallow: /を書いていても、それは学習の希望としては数えられません。__usage_ai-trainingのグループが1つも無いファイルは「希望の表明なし」です- Disallow は「クロール禁止」ではない:このグループの Disallow は「この目的に使わないでほしい」という意味で、クローラーの取得を止める指示ではありません。取得を止めたいなら、今までどおり各社のクローラー名で書きます
- 今までの指定とは別に読まれる:GPTBot や Googlebot のグループは、この草案があってもなくても同じ意味のままです
- 各社ごとの指定を優先してよい:草案は「具体的な指定が一般的な指定より優先されるべき」とし、GPTBot のような各社ごとの名前を、この共通の名前より具体的な指定として扱ってよいとしています
この方式のよいところは、robots.txtの文法を何も変えていないことです。対応していない読み手は、知らない User-Agent のグループとして読み飛ばすだけです。既に出回っている大量のrobots.txtの読み取りプログラムを壊さずに済むので、実装する側が乗りやすい。GoogleとMicrosoftが時期を出したのはこちらでした。
どちらを書けばいいか
Content-Usage | __usage_ai-training | |
|---|---|---|
草案の種類 | 作業部会の草案(合意前) | 個人の草案(作業部会の定義を引用) |
書く場所 | グループの中の新しい行/HTTPヘッダー | User-Agent 行(新しい文法なし) |
示せる目的 | 学習・AIへの入力・検索の3つ | 学習だけ |
読む時期を公表した会社 | 今回の調査では見つからず | Google(2027年初め)・Microsoft(2027-02-01) |
今書く価値 | 低い(読み手が決まっていない) | 高い(読み手と時期が決まっている) |
私の判断は、今は __usage_ai-training を書き、Content-Usage は待つです。合図は、読む側が決まって初めて意味を持ちます。両方書いても害は少ないはずですが、読まれない行を増やすと、次にファイルを触る人が「どれが効いているのか」を判断しにくくなります。
robots.txtに足す手順(4ステップ)
ステップ1:今のrobots.txtを見る
ブラウザで https://自社のドメイン/robots.txt を開きます。WordPressなら設定やプラグインが自動で作っていることがあり、Next.jsなどで作ったサイトはコードの中に生成の処理があります。ファイルを直接置き換える前に、どこで作られているかを確かめてください。
参考までに、fyve.co.jp のrobots.txtを2026年11月1日に確認すると、全体向けの1グループ(/api/ などの除外)とサイトマップの行だけで、AI向けの行は1行もありませんでした。多くの中小企業のサイトも、この状態だと思います。
ステップ2:方針を3つから選ぶ
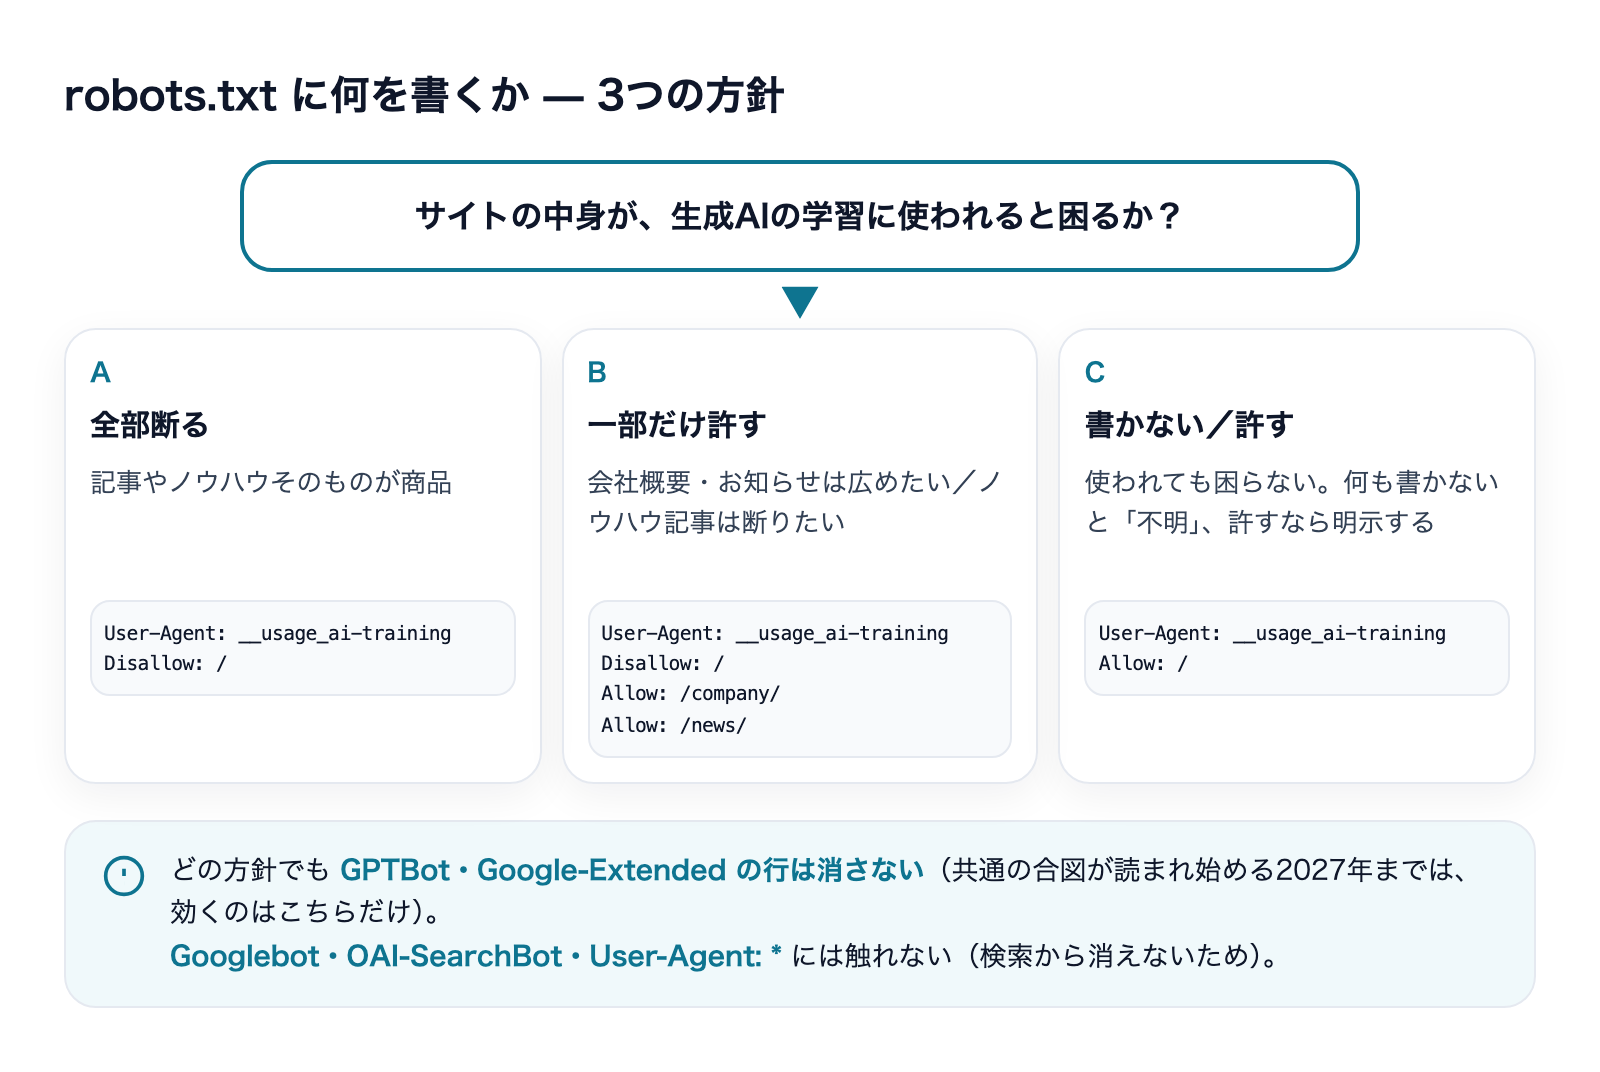
- A. 全部断る:記事やノウハウそのものが商品で、学習に使われると困る
- B. 一部だけ許す:会社概要・プレスリリース・サービス紹介は広く知られてほしいが、有料級のノウハウ記事は断りたい
- C. 何も書かない:学習に使われても困らない、または使われたほうがよい
Cを選ぶ場合も、「何も書かない」は草案の上では「希望の表明なし(不明)」であって「使ってよい」ではありません。積極的に使ってほしいなら、Allow: / を書くと「学習に使ってよい」という表明になります。
ステップ3:グループを足す
Aなら冒頭の4行のとおりです。Bは次のように書きます。草案はrobots.txtと同じく「いちばん長く一致した道の指定」を採るので、許したい道を Allow で足します。
User-Agent: __usage_ai-training
Disallow: /
Allow: /company/
Allow: /news/
書き終えたら、もう一度ブラウザでrobots.txtを開いて、反映されているかを確かめます。CDNのキャッシュで古いファイルが返ることがあります。
ステップ4:今までの各社ごとの指定を残すか決める
ここで GPTBot や Google-Extended の行を消してはいけません。理由は2つあります。
- 共通の合図はまだ誰も読んでいない:Googleは2027年初め、Microsoftは2027年2月1日、OpenAIは「今後数か月」。それまでの間、学習を止める効き目があるのは今までの指定だけです
- 各社の指定が優先されうる:草案は、各社が自分の名前の指定を「より具体的」として優先してよいとしています。共通の合図で「使わないで」と書き、GPTBot には何も書いていない状態なら問題は起きません。ただ、昔の設定で GPTBot に
Allow: /が残っていると、OpenAIがそちらを優先する余地が残ります
Aの方針なら、共通の合図と各社の指定の両方で「使わないで」に揃えておくのが安全です。
よくある間違い4つ
1. 「User-Agent: * で Disallow しているから大丈夫」
これは2つの意味で違います。まず、__usage_ai-training の草案では、* のグループは学習の希望として数えません。次に、全体向けの Disallow: / はGooglebotなどの検索のクローラーも止めるので、検索から消えます。学習だけを断りたいなら、目的の名前のグループで書きます。
2. 「__usage_ai-training で Disallow すれば、AIのクローラーが来なくなる」
来なくなるとは限りません。草案は、この名前は「クロールの指示ではない」と書いています。学習のためだけに集めている会社なら、使えないページの取得を控えることはありえますが、それは各社の任意です。サーバーの負荷を下げたいのが目的なら、各社のクローラー名で取得そのものを止める必要があります。
3. 「学習を断ると、検索やAIの回答から消える」
公式の説明を見る限り、消えません。Googleは「Google-Extended はGoogle検索への掲載に影響せず、順位の要因にも使わない」と明記しています。Bingも、今回の希望は「通常のBing検索の掲載の可否を変えない」としています。OpenAIは、ChatGPTの検索に載せるかを OAI-SearchBot、学習を GPTBot と分けています。
ただし「AIの回答に使われるか」は別の話です。Microsoftは学習とは別に、回答の材料として使うか(AI Grounding)をページごとのメタタグ <meta name="Bingbot" content="ai-grounding:disallow"> で指定させる方式を出しました。__usage_ai-training は学習だけの合図で、回答に使われることまでは止めません。
4. 「書き換えたら、もう学習されたぶんも取り消される」
取り消されません。attach-05 の草案は、robots.txtの変更は「さかのぼって効かない」と書いています。効くのは、クローラーが新しいrobots.txtを取り直し、そのあとでページを取り直してからです。robots.txtは最大24時間使い回されることがあるので、書き換えた直後にも効きません。Microsoftも、対応開始後に全体を取り直すには時間がかかるとしています。
この合図が効かない範囲
書く前に知っておいたほうがよい限界を、草案の原文からまとめます。
- 守るかどうかは受け手の判断:語彙の草案は、この仕組みは「希望が守られることを保証しない」とし、従うかどうかは受け手の選択だと書いています。セキュリティの仕組みでもないと明記しています
- まだ正式な規格ではない:どれもインターネットドラフト(草案)で、RFC(正式な規格)ではありません。草案は最長6か月で差し替えや廃止がありうる「作業中の文書」です。名前や書き方が変わる可能性はあります
- 契約が優先される:データ提供の契約などがあれば、機械で読む希望よりそちらが優先されうると、どちらの草案も書いています
- 人の操作で取りに来るアクセスは別:OpenAIは、ユーザーがChatGPTに頼んでページを見に行く ChatGPT-User について「robots.txtの規則が適用されないことがある」としています
- robots.txtを読まない相手には届かない:合図は、読む側が実装して初めて意味を持ちます
私たちの判断:合図は「読む側の約束」で評価する
私たちはAI検索対策の研究で、llms.txt(AI向けにサイトの要約を置く提案)を追いかけてきました。設置するサイトは増え続けた一方で、他社の調査ではllms.txtの97%がリクエストを1件も受けておらず、主要なAI各社のどこも、本番で読み取っていると公表していませんでした。書く側が熱心でも、読む側が約束しない合図は効かない、というのがそこで得た教訓です。
同じ物差しで今回を見ると、__usage_ai-training は事情が違います。GoogleとMicrosoftが、公式のドキュメントとブログで時期と書き方まで出しました。Content-Usage はまだその段階にありません。だから、今書くなら前者だと判断しました。
一方で、私たちのようにAIに参照されたい側は、学習を断るかどうかを慎重に考える必要があります。AIの回答に自社を出してもらう話(検索・グラウンディング)と、モデルの学習に使われる話は、各社が仕組みを分けています。fyve.co.jp は今のところどちらも断っていません。顧客に説明するときも、「検索とAIの回答からは消えずに、学習だけを断ることはできる。ただし効き始めるのは2027年から」という順で伝えています。
AI検索に自社を出すための対策全体は、こちらでまとめています。
AI検索対策とは?自社をAIに表示させる方法【2026年版】
llms.txtの書き方と、効き目の実態はこちらです。
サイトの側ではなく、自社の業務情報をAIに入れるときの学習の扱いは、こちらで4社を比べています。
公式で確認できなかったこと(ここは断定しません)
- OpenAIがどちらの書き方を読むか:OpenAIの発表の本文は、自動取得を拒否されて読めませんでした。報道の要約は「共通の合図」「今後数か月」「既存の指定は残る」で一致していますが、書き方の名前は出ていません
- Anthropicの対応:草案の著者はAnthropic所属ですが、会社としての対応の発表は確認できませんでした
- Content-Usage を読む会社:時期を約束した会社は、今回の調査では見つかりませんでした
- 日本の法律上の扱い:語彙の草案は、法的な義務が生じる地域にも生じない地域にも使える前提で書かれています。この合図を書くことが日本の著作権法の上でどう扱われるかは、この記事の範囲外です
まとめ
- robots.txtでAIの学習を断るなら、2026年11月1日時点では
User-Agent: __usage_ai-training+Disallow: /を足すのが本命。Googleは2027年初め、Microsoftは2027年2月1日から読むと公式に出しています - 似た書き方の
Content-Usage: train-ai=nは作業部会の草案で、読む時期を約束した会社はまだ見つかっていません User-Agent: *の Disallow は学習の合図として数えられず、検索まで止めてしまいます- GPTBot・Google-Extended などの今までの指定は消さない。共通の合図が読まれ始めるまで、効くのはこちらだけです
- 学習を断っても検索からは消えません。AIの回答に使われるかは、学習とは別の指定です
- どれも草案で、守るかは受け手次第、さかのぼっても効きません
株式会社Fyveでは、AI検索で自社がどう扱われているかの確認から、robots.txtのような技術的な設定までご相談を受けています。